DeepSeek-V3 与本地推理集群:构建低成本企业级 RAG 与 Tool Use 网关
深度求索 DeepSeek-V3 的发布彻底改写了大模型推理性价比格局。本文系统拆解如何利用本地或混合集群部署 DeepSeek-V3,并结合混合检索与严格的 Function Calling 模式,落地千万级知识库与自动化业务工具链。
- 部署环境建议优先配置 FP8 量化权重与多机多卡 Tensor Parallelism,显存成本可缩减超 40%。
- 知识库构建务必采用“向量检索 + BM25 稀疏检索 + 交叉熵重排(Reranker)”三段式漏斗机制,大幅降低噪声召回。
- 对于关键外部系统集成,所有 Function Call 必须运行在带超时控制的独立沙箱环境中。
DeepSeek-V3 稀疏激活与混合检索增强架构
- 1MoE 稀疏激活与张量并行配置
- 2混合向量与稀疏关键词重排检索
- 3严格 JSON Schema 工具调用序列化
- 4降级容灾与本地混合推理网关
架构突破:DeepSeek-V3 带来的算力经济学革命
随着开源大模型生态的蓬勃发展,DeepSeek-V3 的问世为企业落地大模型应用提供了一条兼顾顶级推理能力与极致成本效益的路径。其核心秘密在于结合了多头潜在注意力(Multi-head Latent Attention, MLA)与细粒度稀疏专家混合架构(DeepSeekMoE)。
在每次前向传播过程中,总参数高达 671B 的庞然大物实际仅激活约 37B 参数。这种稀疏激活特性使得单卡吞吐量与首字响应速度(TTFT)实现了数量级的跨越,企业在本地算力受限的情况下,依然能够以消费级到中端企业级硬件搭建出媲美闭源商业模型的专属推理引擎。
工程部署实践:vLLM / SGLang 高并发调优
将 DeepSeek-V3 推向生产环境,选择合适的推理框架至关重要。实践证明,采用 vLLM 或 SGLang 的最新版本,启用 PagedAttention 与连续批处理(Continuous Batching)是保障高并发下低延迟的基础基石。
在显存配置策略上,针对 MoE 架构采用 FP8 量化可以显著降低显存带宽瓶颈。同时,通过合理配置张量并行(TP)与管线并行(PP)组合,不仅可以平摊显存开销,还能使 KV Cache 的利用率逼近理论上限,支撑起上千路并发客服或分析请求。
企业级 RAG 链路重构:拒绝幻觉的高精度召回
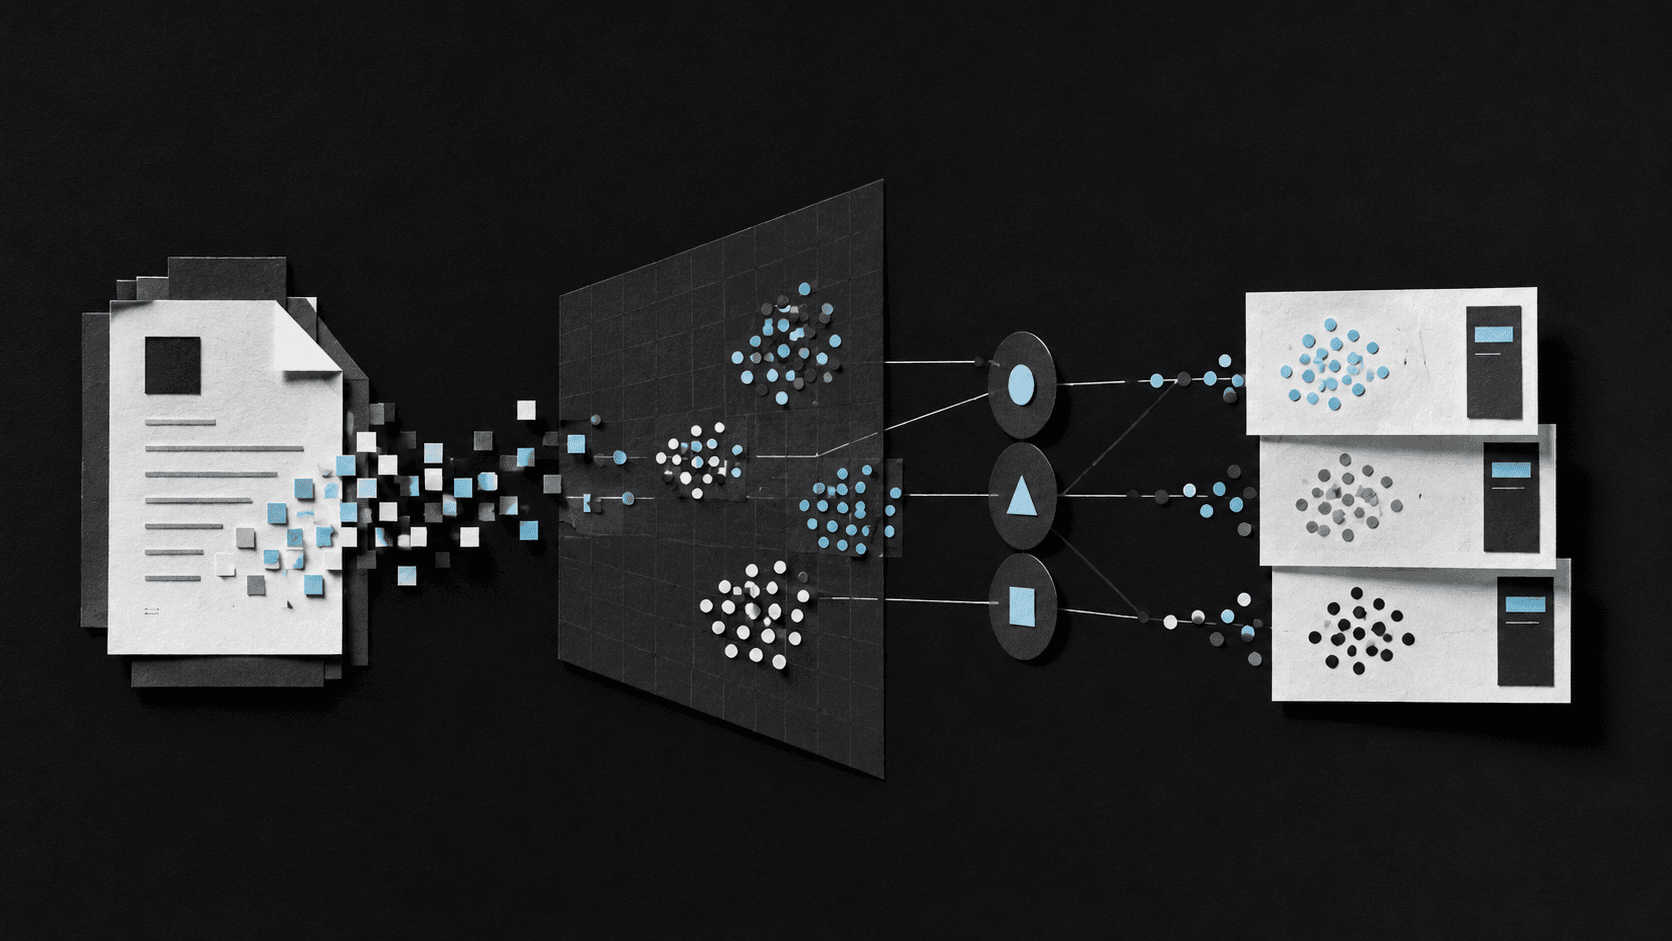
在知识库(RAG)构建方面,单纯依赖 Embedding 密集向量检索已无法满足高精度企业合规场景。结合 DeepSeek-V3 强大的长文本溯源能力,推荐落地混合检索(Hybrid Search)漏斗:先通过向量与 BM25 分别召回 Top 100 候选,再经由 Cross-Encoder 重排器提取 Top 5 核心切片。
由于模型对中文语境下的法条、产品规范及专业术语有着敏锐的辨析度,切片上下文注入提示词后,模型能够准确标注引用来源段落,并在知识库缺失对应信息时果断拒绝回答,真正杜绝捏造幻觉。
Tool Use 闭环:基于强 Schema 约束的企业工具编排
在 Agent 业务落地中,模型不仅要会回答,更要会下发指令调用内部微服务。通过在系统提示词中定义标准的 JSON Schema,并开启强制语法引导解码(Constrained Decoding),DeepSeek-V3 能够输出严丝合缝的调用参数。
从根据用户提问自动查询 CRM 订单状态,到生成包含 SQL 过滤条件的内部报表,配合完备的参数合法性拦截器,企业能够以极低边际成本打通智能体与业务底层数据库的最后一公里。
参考来源
本文由 AI X Tool 基于公开资料研究后原创整理,发布日期与产品信息可能变化,请以来源网站最新内容为准。
本文提到的资源
浏览目录An aggregation API platform for accessing multiple models through one interface.
A China-friendly, cost-effective platform for large-model APIs.
提出 Transformer 架构的奠基性论文。
Andrew Ng's course platform with short courses on modern AI engineering.
A structured way to learn prompt engineering, RAG, and agent techniques.
A public evaluation platform comparing LLM output quality through real-user voting.