企业级 AI 网关架构演进:流式语义缓存、智能限流与多模型容灾回退
在企业落地多大模型混合调用的复杂生产环境中,单点网络波动或供应商服务限流往往造成灾难性级联故障。本文揭秘现代化 AI 网关的核心设计:基于语义相似度的流式缓存、自适应令牌桶限流与零感知无缝容灾调度。
- 语义缓存一定要对用户身份、时效性要求高的敏感提示词进行严格的命名空间隔离与黑名单跳过。
- 流式输出协议必须支持 Server-Sent Events (SSE) 分块增量代理,避免一次性聚合等待损害用户体验。
- 在网关层建立自动化金丝雀发布机制,新模型上线先切 5% 流量进行真实回答质量与延迟观测。
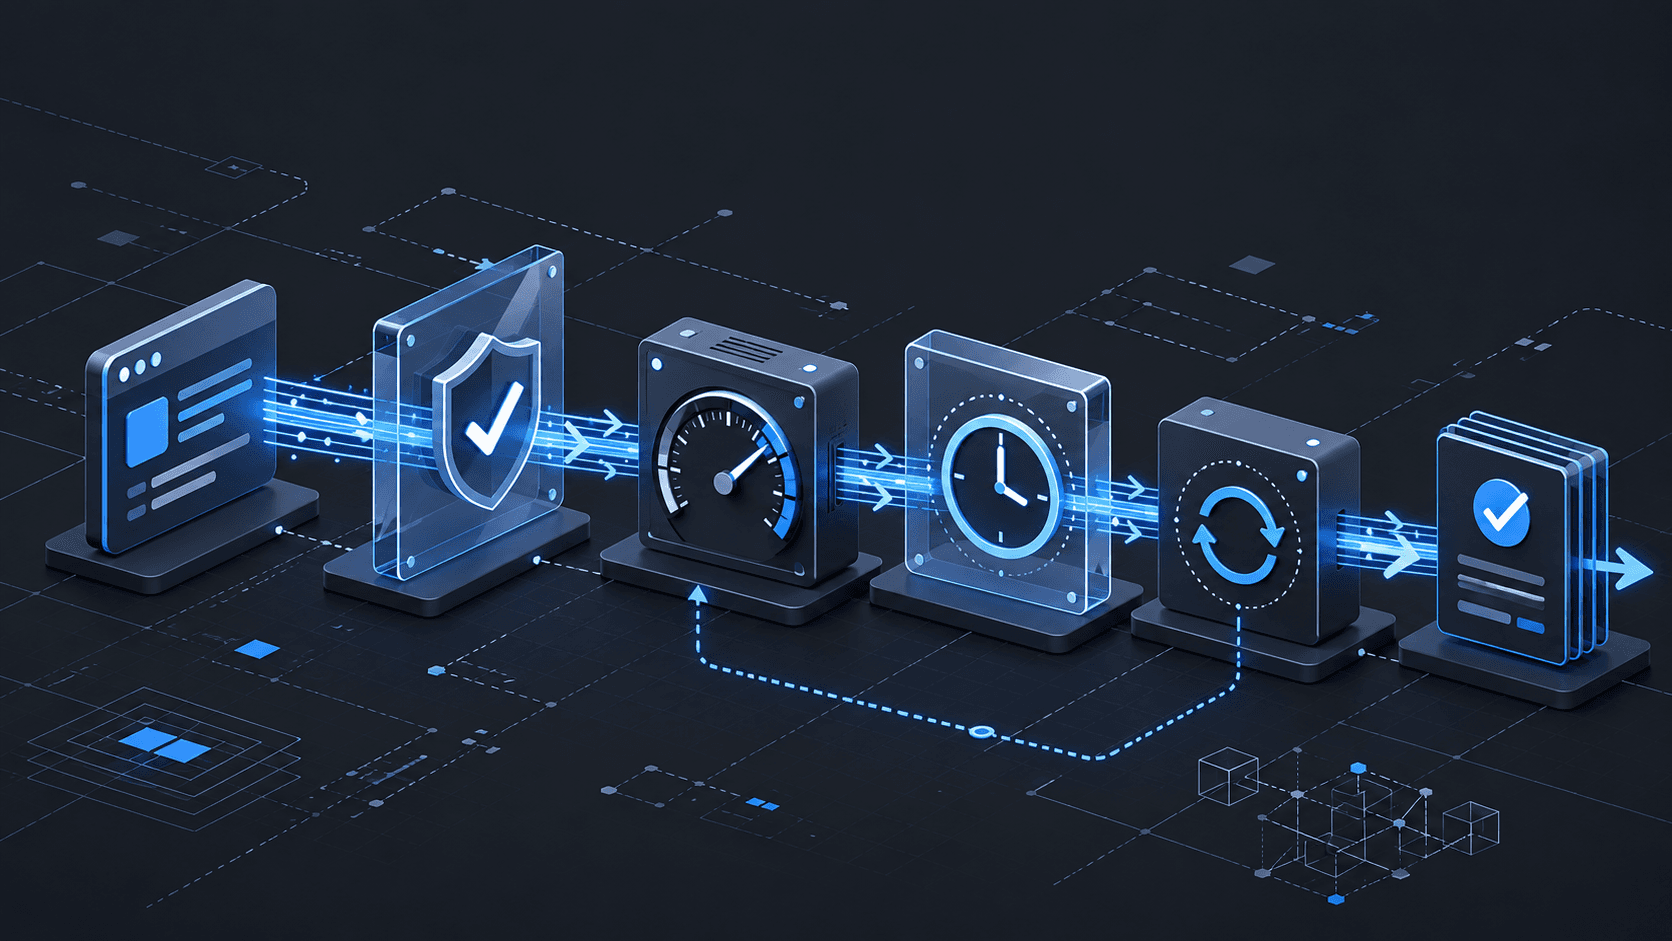
企业级高可用 AI 网关核心转发与熔断拓扑
- 1请求标准化与敏感信息脱敏过滤器
- 2毫秒级流式语义缓存(Semantic Cache)探测
- 3动态配额限流与自适应滑动窗口熔断
- 4跨云双活多模型智能路由降级
架构痛点:直连大模型 API 在生产环境中的脆弱性
许多技术团队在初期原型开发时,习惯在前端或单个微服务中直接通过 SDK 调用上游模型 API。但在业务规模扩大后,这种点对点直连架构迅速暴露出严重缺陷:厂商突发宕机导致业务全面瘫痪、超出每分钟调用配额(TPM/RPM)遭遇频繁 429 拦截、不同模型接口协议各异导致维护成本高昂。
构建统一的现代化‘企业级 AI 网关(AI Gateway)’,成为企业大模型架构从玩具走向稳健生产系统的必经之路。
流式语义缓存(Semantic Cache):毫秒级响应与降本神器
传统 HTTP 缓存基于请求 URL 和请求头的字符串完全哈希匹配,面对用户表述稍有差异(如‘怎么退货’与‘退换货流程是什么’)的提问完全失效。AI 网关通过前置一个极轻量、超高速的向量嵌入模型,在 Redis 或专用向量库中进行相似度余弦探测。
当相似度高于预设安全阈值(如 0.95)时,网关直接读取缓存中历史生成的回答并以 SSE 流式格式秒级推流返回。不仅将用户首字等待延迟(TTFT)从 2000ms 降至 20ms,更能直接削减企业数十个百分点的大模型 Token 采购成本。
高可用韧性设计:自适应限流、健康探测与透明容灾
生产级网关的核心使命是保障服务不中断。网关内置了动态令牌桶限流器,按照组织、部门和 API Key 划分独立的速率与消费预算。一旦某项目接近预算红线,网关将及时采取降频保护,避免意外代码死循环耗尽全月额度。
更关键的是跨供应商故障转移(Failover)能力。网关对上游每个模型端点实施主动与被动健康探测。当主模型集群连续出现超时或 5xx 错误时,熔断器立即切断流量,并按照预设的权重备选链路(如从 Claude 3.5 无缝转入 DeepSeek-V3 或 GPT-4o),终端用户完全无感中断。
安全与合规审计:企业数字资产的守门人
除了性能与可用性,AI 网关还是企业数据安全的关键防线。所有进出网关的 Prompt 与 Completion 都会经历实时的正则脱敏与敏感词过滤,防止手机号、身份证和内部源码等涉密信息泄露至公共模型云端。
全链路记录的日志、成本账单及性能打点数据,被统一汇总至监控大屏,为企业技术决策层提供了清晰的各业务线 AI 投资回报率(ROI)视图与长线治理依据。
参考来源
本文由 AI X Tool 基于公开资料研究后原创整理,发布日期与产品信息可能变化,请以来源网站最新内容为准。
本文提到的资源
浏览目录An aggregation API platform for accessing multiple models through one interface.
A China-friendly, cost-effective platform for large-model APIs.
提出 Transformer 架构的奠基性论文。
Andrew Ng's course platform with short courses on modern AI engineering.
A structured way to learn prompt engineering, RAG, and agent techniques.
A public evaluation platform comparing LLM output quality through real-user voting.