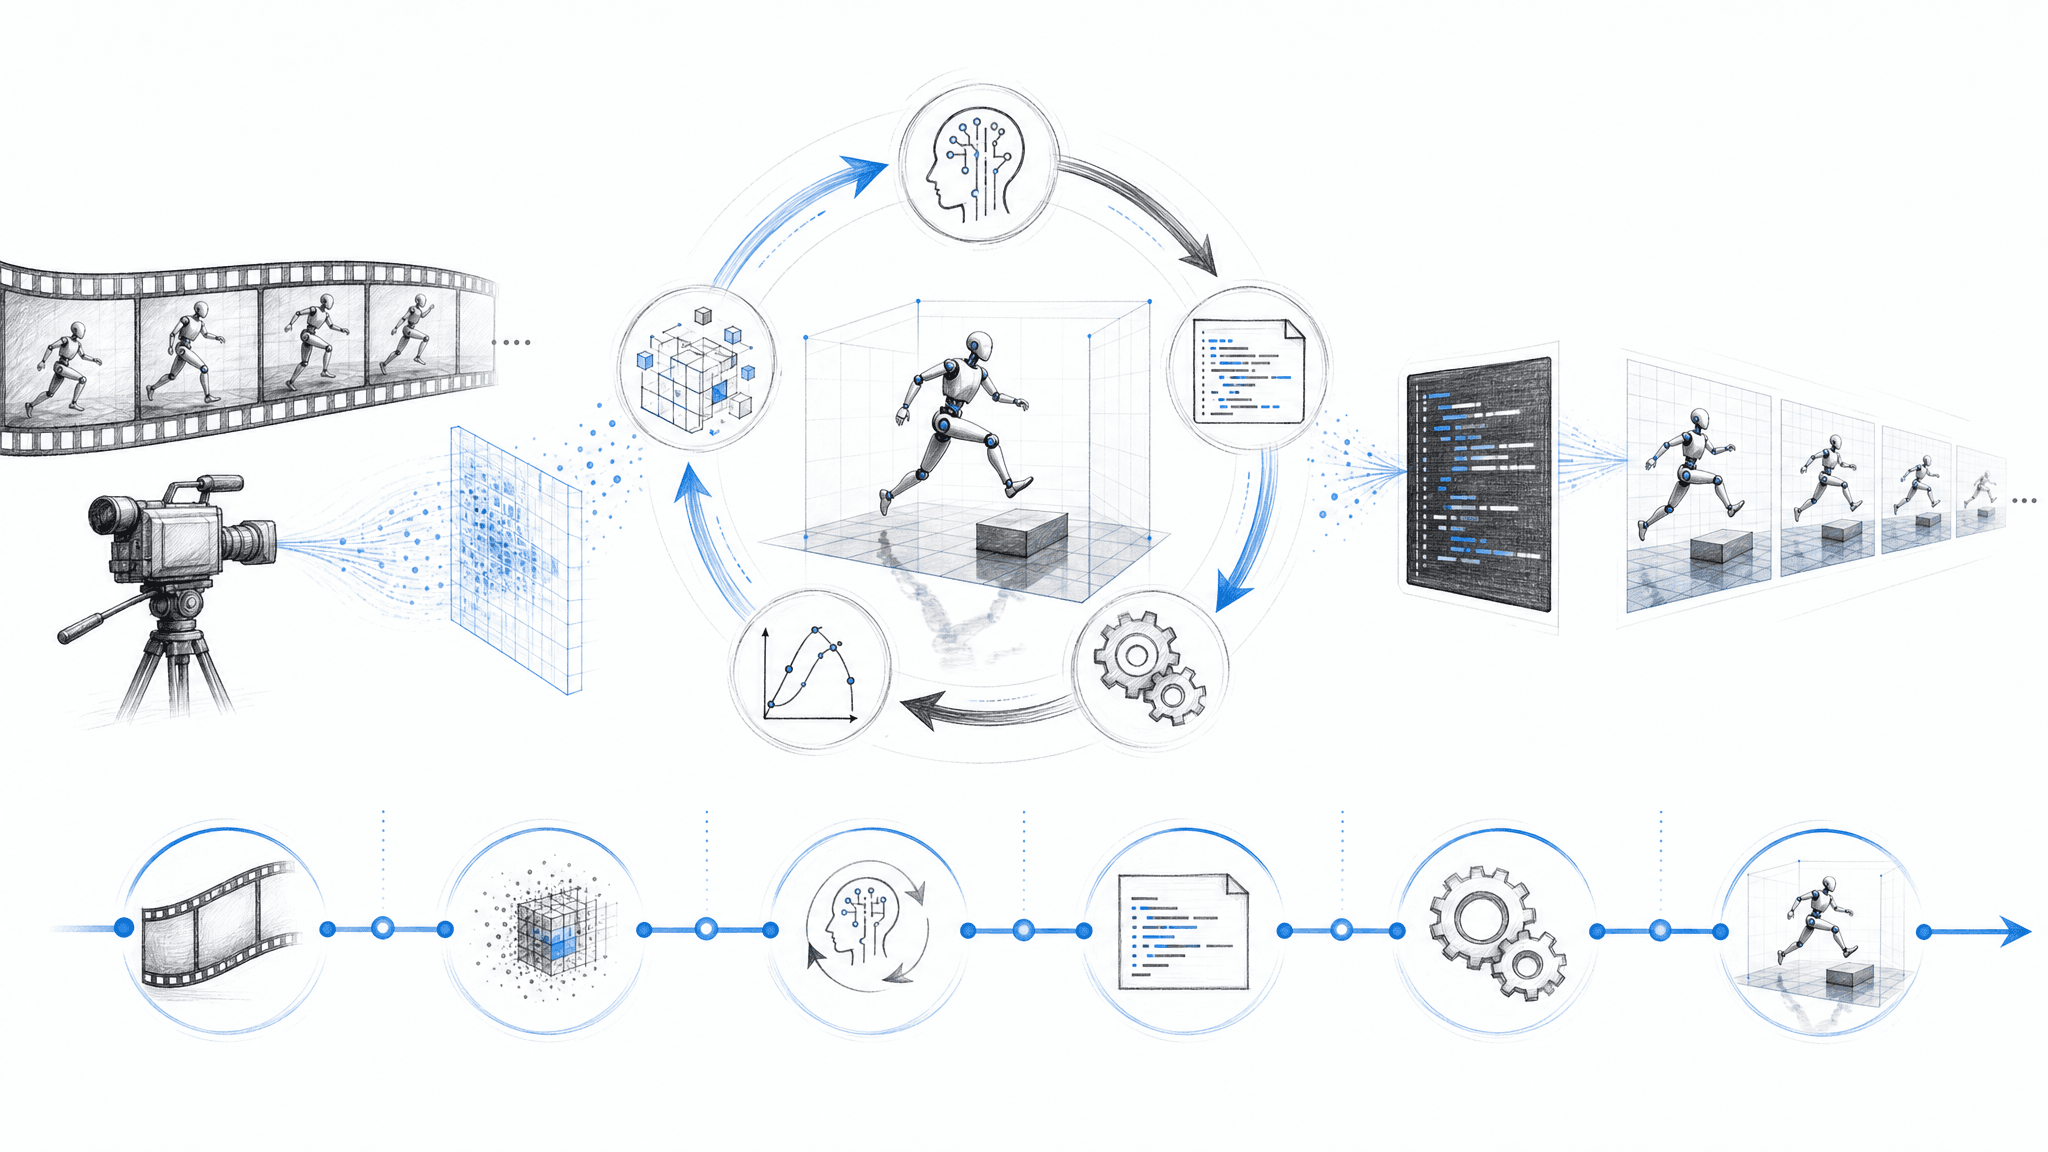
Meet ‘Code-as-World’: An Agentic Loop That Rewrites Real Videos Into Executable MuJoCo Physics Programs
Code-as-World recovers editable MuJoCo scene code from real video, then uses those verified worlds to train physical reasoning. The post Meet ‘Code-as-World’: An Agentic Loop That Rewrites Real Videos Into Executable MuJoCo Physics Programs appeared first on MarkTechPost .
- 先核对来源和时间
- 把试用限制在可回滚范围
- 对缺少独立证据的结论保持观望
事件时间线
- 1事件时间线
- 2关键机制
- 3真实使用场景
- 4限制与复核
发生了什么
MirroS 推出了名为 Code-as-World 的范式,核心思路是把物理场景编码成可执行程序,最终生成 scene.json 并交由 MuJoCo 物理引擎运行。系统采用智能体循环结构,从一段真实视频出发反复试错与改写,最多进行 5 轮迭代,逐步逼近可被物理引擎重建的场景程序。
为了让方案可直接复用,官方同步开源了 GitHub 仓库,并释出两个模型检查点:Code-as-World-VL-4B 与 Code-as-World-VL-9B,均采用 Apache 2.0 许可。两个模型分别由 Qwen3.5-4B 与 Qwen3.5-9B 微调得到,以 BF16 safetensors 形式部署,通过 vLLM 提供服务,并对外暴露兼容 OpenAI 规范的 /v1 接口。推理时,每段输入视频会被采样为 16 帧,同时把 `--max-model-len` 设为 4608。
可执行世界表示 EWR 被形式化为三元组 p = (C, E, A),分别对应场景构成、状态演化与外观渲染三部分,用以统一刻画可被 MuJoCo 复现的世界。在实现链路中,团队组合了三类视觉模型:SAM 3 负责实例掩码并输出图像平面轨迹,VGGT-Omega 提供深度与相机几何估计,SAM 3D 则逐物体重建网格几何。
训练分为两个阶段。第一阶段使用 73,335 个图像空间问答对进行监督微调;第二阶段引入世界空间样本,包含 1,585 条文本驱动与 988 条视频驱动的可执行世界数据,并在此基础上施加 GRPO 训练。整套训练消耗 8 块 NVIDIA H100 GPU 完成。
在 QuantiPhy 验证集(159 项、采用 MRA 宏平均,覆盖 2S/2D/3S/3D 四类设置)上,4B 与 9B 版本分别取得 50.6 与 55.4,27B 推理版本进一步升至 58.6。对比同基准结果,Gemini-3.1 Flash 得 54.8,ChatGPT-5.1 得 48.4,Qwen3-VL-32B-Instruct 得 40.2。消融实验表明,仅依赖图像空间训练时,4B 与 9B 分别只有 44.2 与 50.9;加入两类世界空间数据后,分别提升至 50.6 和 55.4,验证了世界空间监督与 GRPO 的贡献。
时间线与证据
来源材料给出的最早可核对时间点是网页发布时间 2026-08-30T01:35:02+00:00,材料中并未单独标注 Code-as-World 范式的正式发布日,相关披露与开源动作均在同一时间窗内由 MirroS 一并放出:GitHub 仓库、两个模型检查点以及配套技术报告同步公开。
项目落地的关键事件按先后顺序可梳理为三条线。第一条是模型与代码资产线,仓库释出同时附带 Code-as-World-VL-4B 与 Code-as-World-VL-9B 两个 BF16 safetensors 检查点,均采用 Apache 2.0 许可,前者由 Qwen3.5-4B 微调而来,后者基于 Qwen3.5-9B,并统一通过 vLLM 提供兼容 OpenAI 规范的 /v1 接口,推理侧固定每段视频采样 16 帧并将 `--max-model-len` 设为 4608。第二条是表示与实现线,团队把可执行世界表示 EWR 形式化为 p = (C, E, A) 三元组,分别刻画构成、演化与外观,并组合 SAM 3、VGGT-Omega、SAM 3D 三类模型完成实例掩码、图像平面轨迹、深度与相机几何以及逐物体网格重建,最终生成 scene.json 交由 MuJoCo 运行。第三条是训练与评测线,模型训练先后经历图像空间 73,335 对问答对的监督微调,以及在 1,585 条文本驱动与 988 条视频驱动可执行世界数据上施加 GRPO,消耗 8 块 NVIDIA H100 GPU 完成;评测端使用 QuantiPhy 验证集的 159 项、MRA 宏平均、覆盖 2S/2D/3S/3D 四类设置,得到 4B 50.6、9B 55.4、27B 推理版本 58.6 的结果,并给出 Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4、Qwen3-VL-32B-Instruct 40.2 的对照数字。
具体变化
相比此前的视觉理解方案,Code-as-World 把输出形式从文字描述或检测框改为可被 MuJoCo 直接执行的 scene.json 程序。为支撑这一改变,团队引入了三类视觉模型协同工作:SAM 3 给出实例掩码与图像平面轨迹,VGGT-Omega 提供深度与相机几何,SAM 3D 负责逐物体重建网格几何,三者输出共同驱动代码生成。
在模型侧,官方同步放出两个 BF16 safetensors 检查点 Code-as-World-VL-4B 与 Code-as-World-VL-9B,分别由 Qwen3.5-4B 与 Qwen3.5-9B 微调而来,统一经由 vLLM 对外暴露兼容 OpenAI 规范的 /v1 接口。推理侧固定每段视频采样 16 帧,并把 `--max-model-len` 设为 4608。
训练安排也做了相应调整。第一阶段使用 73,335 个图像空间问答对进行监督微调;第二阶段转向世界空间,引入 1,585 条文本驱动与 988 条视频驱动的可执行世界样本,并施加 GRPO 训练,硬件上消耗 8 块 NVIDIA H100 GPU 完成。
评测端采用 QuantiPhy 验证集,159 项任务、以 MRA 宏平均,覆盖 2S、2D、3S、3D 四类设置。结果显示,4B 版本得分 50.6,9B 版本升至 55.4,27B 推理版本进一步达到 58.6;同期对照 Gemini-3.1 Flash 取得 54.8,ChatGPT-5.1 取得 48.4,Qwen3-VL-32B-Instruct 取得 40.2。消融实验中,仅依赖图像空间训练时 4B 与 9B 分别仅有 44.2 与 50.9,加入两类世界空间数据后分别提升至 50.6 与 55.4,说明世界空间监督与强化学习训练共同推动了性能变化。
对使用者的影响
对于希望用真实视频驱动物理仿真的研究者与工程师,Code-as-World 把输入从人工标注的物体参数换为一段视频,配合最多 5 轮的智能体循环重写,输出可直接交由 MuJoCo 运行的 scene.json,免去手工搭建场景的步骤。
部署门槛方面,官方释出的两个 Apache 2.0 检查点 Code-as-World-VL-4B 与 Code-as-World-VL-9B 分别基于 Qwen3.5-4B 与 Qwen3.5-9B,以 BF16 safetensors 形式经由 vLLM 提供服务,并通过兼容 OpenAI 规范的 /v1 接口对外暴露,调用侧只需按每段视频采样 16 帧并把 `--max-model-len` 设为 4608 即可启动推理,模型与上游基座的归属关系在仓库中标注清晰,便于二次微调或替换。
效果上,使用者拿到的不只是文字描述,而是可被 MuJoCo 复现的可执行世界表示 EWR,其三元组 p = (C, E, A) 分别对应构成、状态演化与外观渲染,配合 SAM 3 实例掩码与图像平面轨迹、VGGT-Omega 深度与相机几何以及 SAM 3D 逐物体网格,可直接用于下游物理仿真、控制策略训练或具身智能任务。
QuantiPhy 验证集(159 项、MRA 宏平均、覆盖 2S/2D/3S/3D)的对比结果显示,4B 与 9B 版本分别取得 50.6 与 55.4,27B 推理版本进一步升至 58.6,优于同基准下的 Gemini-3.1 Flash(54.8)、ChatGPT-5.1(48.4)以及 Qwen3-VL-32B-Instruct(40.2),让中小参数规模模型在物理推理任务中也能取得相对靠前的名次。
训练流程同样开放,使用者可以参照两阶段路线复现:第一阶段在 73,335 个图像空间问答对上做监督微调,第二阶段引入 1,585 条文本驱动与 988 条视频驱动的可执行世界数据并施加 GRPO,整个过程使用 8 块 NVIDIA H100 GPU 完成,为后续在自有数据上做继续训练或强化学习微调提供了可对齐的基线脚本与硬件预算参考。
限制与未知
来源材料在多个关键处留下了未交代的细节,使用者按现有公开信息难以获得确切答复。
在时间维度上,网页发布时间 2026-08-30T01:35:02+00:00 是目前唯一可核对的客观时间戳,材料并未单独披露 Code-as-World 范式的正式发布日,也无法判断训练完成、开源、报告成稿等节点之间的时间间隔。
在模型资产层面,27B 推理版本的具体名称、是否同步开源、是否同样采用 Apache 2.0 许可以及如何获得,材料中均未给出,只能确认其在 QuantiPhy 验证集上取得 58.6 这一结果。
在数据构建层面,73,335 个图像空间问答对的来源筛选规则与构建细节未在材料中给出,其内部是否细分为 RefCOCO/RefCOCO+/RefCOCOg、RefCLEF、GOT-10K 等子集以及各自数量比例同样未披露。
在训练策略层面,第二阶段使用的 GRPO 具体超参与奖励权重数值未在材料中给出,无法据此判断训练成本与效果之间的权衡;候选视频经过运动聚焦过滤后剩余的具体数量也未公开,5 轮评测预算下与 Best-of-5 独立采样之间的具体数值差距亦未提供。
在评测层面,材料仅说明 QuantiPhy 验证集包含 159 项、采用 MRA 宏平均、覆盖 2S/2D/3S/3D 四类设置,但每类设置下样本数量分布以及 27B 版本是否在完全相同的设置下评测未做说明。
如何核对
要核对 Code-as-World 的各项细节,使用者可顺着范式名称与作者署名回到源头。MarkTechPost 网页正文明确署名为 MirroS 发布,文末给出 GitHub 仓库链接,并附上技术报告与 Code-as-World-VL-4B、Code-as-World-VL-9B 两个模型卡页面,模型卡页面可直接确认 Apache 2.0 许可条款与 BF16 safetensors 权重格式,从权重卡片能够读到基座分别标注为 Qwen3.5-4B 与 Qwen3.5-9B。
推理侧的具体数值同样需要在仓库的部署脚本或 README 中核对。网页摘要给出的两条设置是每段视频采样 16 帧与 `--max-model-len 4608`,使用者应检查仓库内的 serve 或 launch 脚本,确认命令行参数名称、是否仅在 OpenAI 兼容 `/v1` 接口下生效,以及默认采样策略是否一致。
视觉模型栈的归属可通过论文附录或仓库依赖列表核对。网页摘要列出的三项组件 SAM 3 实例掩码与图像平面轨迹、VGGT-Omega 深度与相机几何、SAM 3D 逐物体网格,应在论文的模型章节对应到具体版本号与权重来源,确认三者输出是否确实汇入 scene.json 的构成、演化与外观三元组 p = (C, E, A)。
训练流程的核对重点在两阶段数据规模与硬件配置。第一阶段 73,335 个图像空间问答对、第二阶段 1,585 条文本驱动与 988 条视频驱动样本,以及 8 块 NVIDIA H100 GPU 的设置,应在技术报告或仓库训练配置文件中找到对应数字,并留意是否注明数据来源筛选规则。
评测结果的核对应回到 QuantiPhy 验证集原条目,确认其包含 159 项、采用 MRA 宏平均、覆盖 2S、2D、3S、3D 四类设置,再把网页给出的 4B 50.6、9B 55.4、27B 推理版本 58.6、Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4 与 Qwen3-VL-32B-Instruct 40.2 逐项对齐。消融实验中仅图像空间训练得到的 44.2 与 50.9,以及加入两类世界空间数据后的 50.6 与 55.4,也应在报告消融表格中找到相同来源。
材料未明确给出 27B 推理版本名称、GRPO 超参与奖励权重、候选视频经运动聚焦过滤后的剩余数量,以及 Best-of-5 独立采样与 5 轮预算的具体差距,使用者遇到相关问题应直接联系作者或在仓库 issue 中求证,而非基于网页摘要推断。
读者能做什么
读者可以直接前往 MirroS 在 MarkTechPost 文末给出的 GitHub 仓库,下载 Code-as-World-VL-4B 与 Code-as-World-VL-9B 两个 Apache 2.0 检查点,按模型卡页面记录的 BF16 safetensors 格式与 Qwen3.5-4B、Qwen3.5-9B 基座归属完成权重加载,并通过 vLLM 暴露的兼容 OpenAI 规范的 `/v1` 接口发起请求,把命令行中每段视频采样 16 帧与 `--max-model-len` 设为 4608 作为最小推理配置。
拿到模型后,读者只需向智能体循环投入一段真实视频,由其在最多 5 轮内反复改写,最终输出可直接交由 MuJoCo 运行的 scene.json,从而跳过手工搭建物体参数与场景布线的步骤,把可执行世界表示 EWR 的三元组 p = (C, E, A) 立即接入下游物理仿真、控制策略训练或具身智能任务。
若计划在自有数据上继续训练,可以参照仓库内公开的两阶段脚本:先用 73,335 个图像空间问答对做监督微调,再在 1,585 条文本驱动与 988 条视频驱动的可执行世界数据上施加 GRPO,整套流程在 8 块 NVIDIA H100 GPU 上完成,为继续微调或强化学习对齐提供可复用的基线预算。
在 QuantiPhy 验证集(159 项、MRA 宏平均、覆盖 2S/2D/3S/3D)上,本地复跑 4B 与 9B 即可对照 50.6 与 55.4 这两个官方分数,并参考同基准下 Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4 与 Qwen3-VL-32B-Instruct 40.2 验证自家部署是否一致;消融实验中仅图像空间训练得到的 44.2 与 50.9,以及加入两类世界空间数据后回到 50.6 与 55.4 的曲线,也可在同一基准上重测以确认世界空间监督与 GRPO 的实际增益。
后续观察
从消融曲线可以看出,世界空间监督与 GRPO 是模型从图像空间能力迁移到可执行世界表示的关键推力。仅靠 73,335 个图像空间问答对做监督微调,4B 与 9B 在 QuantiPhy 上分别只有 44.2 与 50.9;叠加 1,585 条文本驱动与 988 条视频驱动的可执行世界数据后,两个模型立即回升到 50.6 与 55.4,与最终公开分数完全对齐,说明这部分数据带来的增益相对集中且方向单一。
值得注意的是,27B 推理版本虽然未公布名称与权重,却在同一验证集上把分数推到 58.6,超过同基准下 Gemini-3.1 Flash 的 54.8,也明显领先 ChatGPT-5.1 的 48.4 与 Qwen3-VL-32B-Instruct 的 40.2。这条曲线意味着在物理一致性这种结构化判断任务里,中小参数规模模型叠加程序化中间表示后,仍有继续上探的空间,同时也让 4B 与 9B 的相对位置更接近可用基线,而非纯粹依赖规模取胜。
对工程使用而言,5 轮智能体循环把输出锁定在 MuJoCo 可直接读取的 scene.json,配合 SAM 3 实例掩码与图像平面轨迹、VGGT-Omega 深度与相机几何、SAM 3D 逐物体网格这一视觉栈,意味着从原始视频到可执行物理场景的整条链路都不需要用户手工接入额外几何重建模块,可直接进入下游仿真或策略训练。
随着 Apache 2.0 同时覆盖代码、权重与技术报告,社区可以在 Qwen3.5-4B 与 Qwen3.5-9B 之上继续做微调或强化学习,而 8 块 NVIDIA H100 的硬件门槛也为后续复现提供了相对明确的预算参考。
参考来源
本文由 AI X Tool 基于公开资料研究后原创整理,发布日期与产品信息可能变化,请以来源网站最新内容为准。