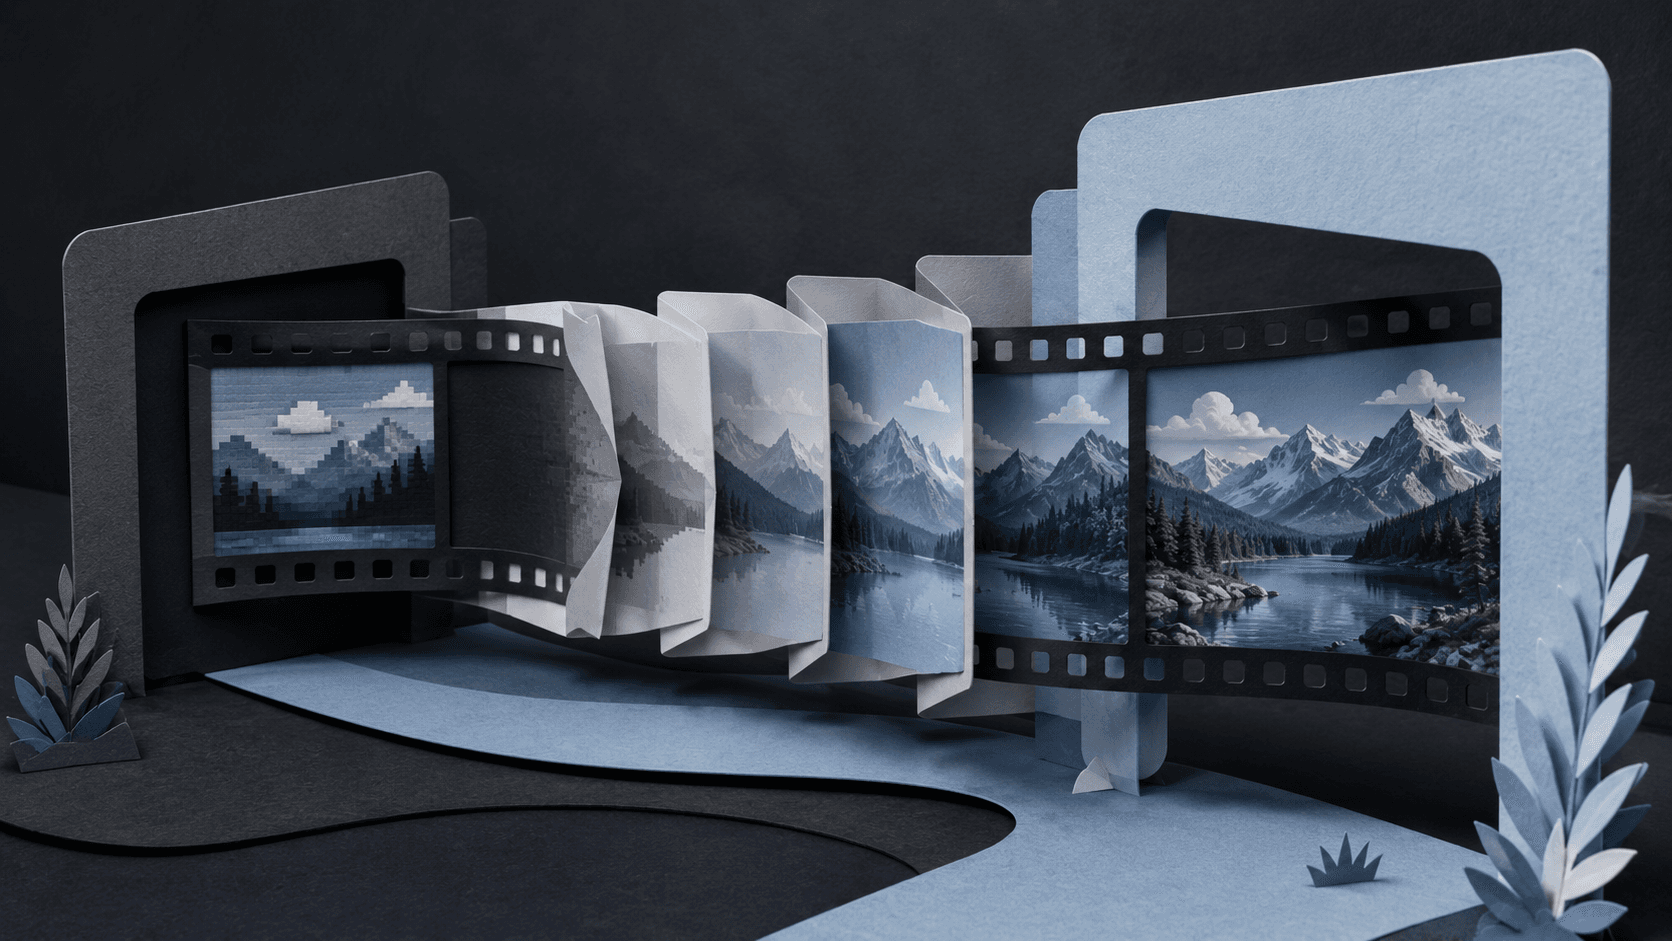
多模态视频生成与时间线控制:从首尾帧锚定到分镜连续性实战
视频生成技术正从“随机盲盒生成”迈向“可控参数化导演”。本文深入剖析如何通过首尾帧关键帧锁定(First/Last Frame Control)、深度图引导与时间线分镜拆解,打造商业级长视频与动态分镜工作流。
- 绝对不要在一个 5 秒视频的单一提示词中堆砌过多连贯动作,遵循‘一个镜头传达一个主体动量’的影视构图准则。
- 将前一个镜头的最终生成帧作为下一个镜头的起始帧,是串联分钟级故事片最稳妥的连续性技巧。
- 出片时统一保留元数据与运动矢量标记,便于在后期剪辑软件中进行变速曲线与调色匹配。
视频生成首尾帧插值与时间线连续性管线
- 1剧本拆分与镜头语言标准化(Shot Breakdown)
- 2静态首尾帧生成与角色资产特征对齐
- 3运动轨迹、摄影机运镜与物理约束生成
- 4时空潜空间插值与分段无缝融合渲染
技术演进:从盲盒式文本生视频到导演级精确制导
早期文本生成视频工具常被从业者戏称为‘算力抽卡’——输入一段唯美的提示词,输出的画面虽然视觉惊艳,但往往充斥着不自然的多肢体、物体溶解以及无法预测的运镜穿模。在需要精确剧情把控的广告营销与影视制作中,这种不可预测性极大制约了商业化落地。
而新一代视频基础模型(如 Sora、Runway Gen-3 以及 Gemini Omni 系列)的核心变革,在于引入了对物理时空连续性与多模态条件的深度控制能力。视频创作者开始拥有与传统三维软件类似的镜头控制权。
首尾帧控制(First/Last Frame):锁死动作起点与终点
在可控视频管线中,‘首尾帧锁定’被证明是最具工业价值的核心功能。创作者可以通过高精度的文生图或实拍素材指定镜头的第 0 秒画面(首帧)与第 5 秒画面(尾帧)。
扩散模型在此基础上的任务从‘凭空想象时空’转变为‘在两帧之间计算最符合现实物理规律的运动插值路径’。这不仅彻底解决了角色面部与环境光影在运镜中的跳跃问题,更允许复杂的交互动作(如杯子从桌上拿起移至嘴边)能够精确到达指定位置。
多镜头叙事策略:角色一致性与镜头接戏(Continuity)
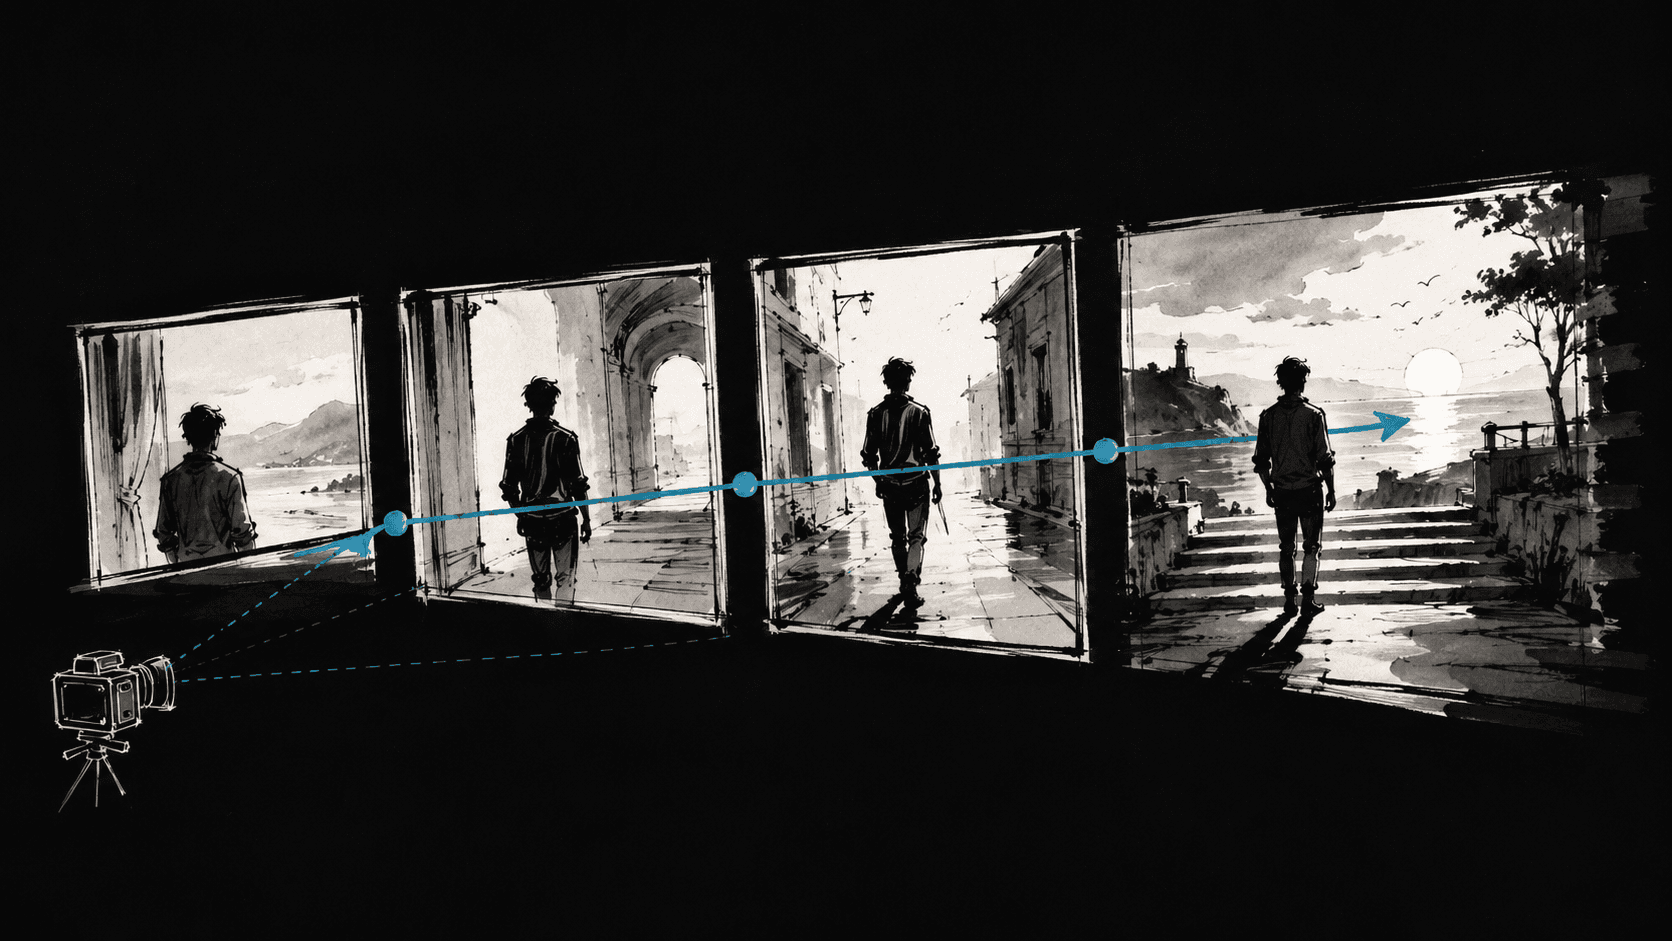
制作一部完整的剧情短片需要数十个分镜。如何在不同景别(特写、中景、全景)之间保持同一角色和环境的视觉特征?实践中成熟的工作流是建立‘角色视觉资产包’。
利用参考图像嵌入(Reference Latent Embedding)或专属微调权重,先批量产出多角度的角色立绘。在生成具体镜头时,将角色资产作为恒定条件传入,同时严格将上一个镜头的尾帧提取为下一个镜头的视觉基准,确保镜头交接处的景深和色调浑然一体。
工业化渲染管线:降本提效的二阶段工作流
高分辨率视频生成极其昂贵且耗时。高效的制作流程必然遵循‘草稿验证 -> 终稿上采样’的二阶段法则。前期用 360p 或 540p 极速模式跑通全部分镜的分镜脚本与动效节奏,确认剪辑轴线无误后再开启 1080p 或 4K 的高质量渲染。
通过将现代视频大模型与成熟的非线性编辑工具相结合,独立创作者与小型制作团队正以惊人的效率产出过去需要好莱坞特效团队数月才能完成的动态视觉大片。
参考来源
本文由 AI X Tool 基于公开资料研究后原创整理,发布日期与产品信息可能变化,请以来源网站最新内容为准。
本文提到的资源
浏览目录An aggregation API platform for accessing multiple models through one interface.
A China-friendly, cost-effective platform for large-model APIs.
提出 Transformer 架构的奠基性论文。
Andrew Ng's course platform with short courses on modern AI engineering.
A structured way to learn prompt engineering, RAG, and agent techniques.
A public evaluation platform comparing LLM output quality through real-user voting.