DeepSeek-V3 與本機推理集群:建構低成本企業級 RAG 與 Tool Use 閘道
深度求索 DeepSeek-V3 的發布彻底改寫了大模型推理性價比格局。本文系統拆解如何利用本機或混集合群部署 DeepSeek-V3,並結合混合檢索與严格的 Function Calling 模式,落地千萬級知識庫與自動化業務工具鏈。
- 部署環境建議優先設定 FP8 量化權重與多機多卡 Tensor Parallelism,顯存成本可缩减超 40%。
- 知識庫建構務必採用“向量檢索 + BM25 稀疏檢索 + 交叉熵重排(Reranker)”三段式漏斗機制,大幅降低噪聲召回。
- 對於關鍵外部系統整合,所有 Function Call 必須執行在帶逾時控制的獨立沙箱環境中。
DeepSeek-V3 稀疏激活與混合檢索增強架構
- 1MoE 稀疏激活與张量並行設定
- 2混合向量與稀疏關鍵字重排檢索
- 3严格 JSON Schema 工具呼叫序列化
- 4降級容灾與本機混合推理閘道
架構突破:DeepSeek-V3 帶來的算力經济學革命
隨着開源大模型生態的蓬勃發展,DeepSeek-V3 的問世為企業落地大模型應用提供了一條兼顾顶級推理能力與极致成本效益的路径。其核心秘密在於結合了多頭潜在注意力(Multi-head Latent Attention, MLA)與细粒度稀疏專家混合架構(DeepSeekMoE)。
在每次前向傳播過程中,總參數高達 671B 的庞然大物實際僅激活約 37B 參數。這種稀疏激活特性使得單卡吞吐量與首字響應速度(TTFT)實現了數量級的跨越,企業在本機算力受限的情況下,依然能夠以消費級到中端企業級硬件搭建出媲美閉源商業模型的專屬推理引擎。
工程部署實踐:vLLM / SGLang 高並發調優
將 DeepSeek-V3 推向生產環境,選擇合適的推理框架至關重要。實踐證明,採用 vLLM 或 SGLang 的最新版本,啟用 PagedAttention 與連續批處理(Continuous Batching)是保障高並發下低延遲的基礎基石。
在顯存設定策略上,針對 MoE 架構採用 FP8 量化可以顯著降低顯存帶寬瓶颈。同時,通過合理設定张量並行(TP)與管線並行(PP)組合,不僅可以平摊顯存開销,還能使 KV Cache 的利用率逼近理論上限,支撑起上千路並發客服或分析請求。
企業級 RAG 鏈路重構:拒绝幻覺的高精度召回
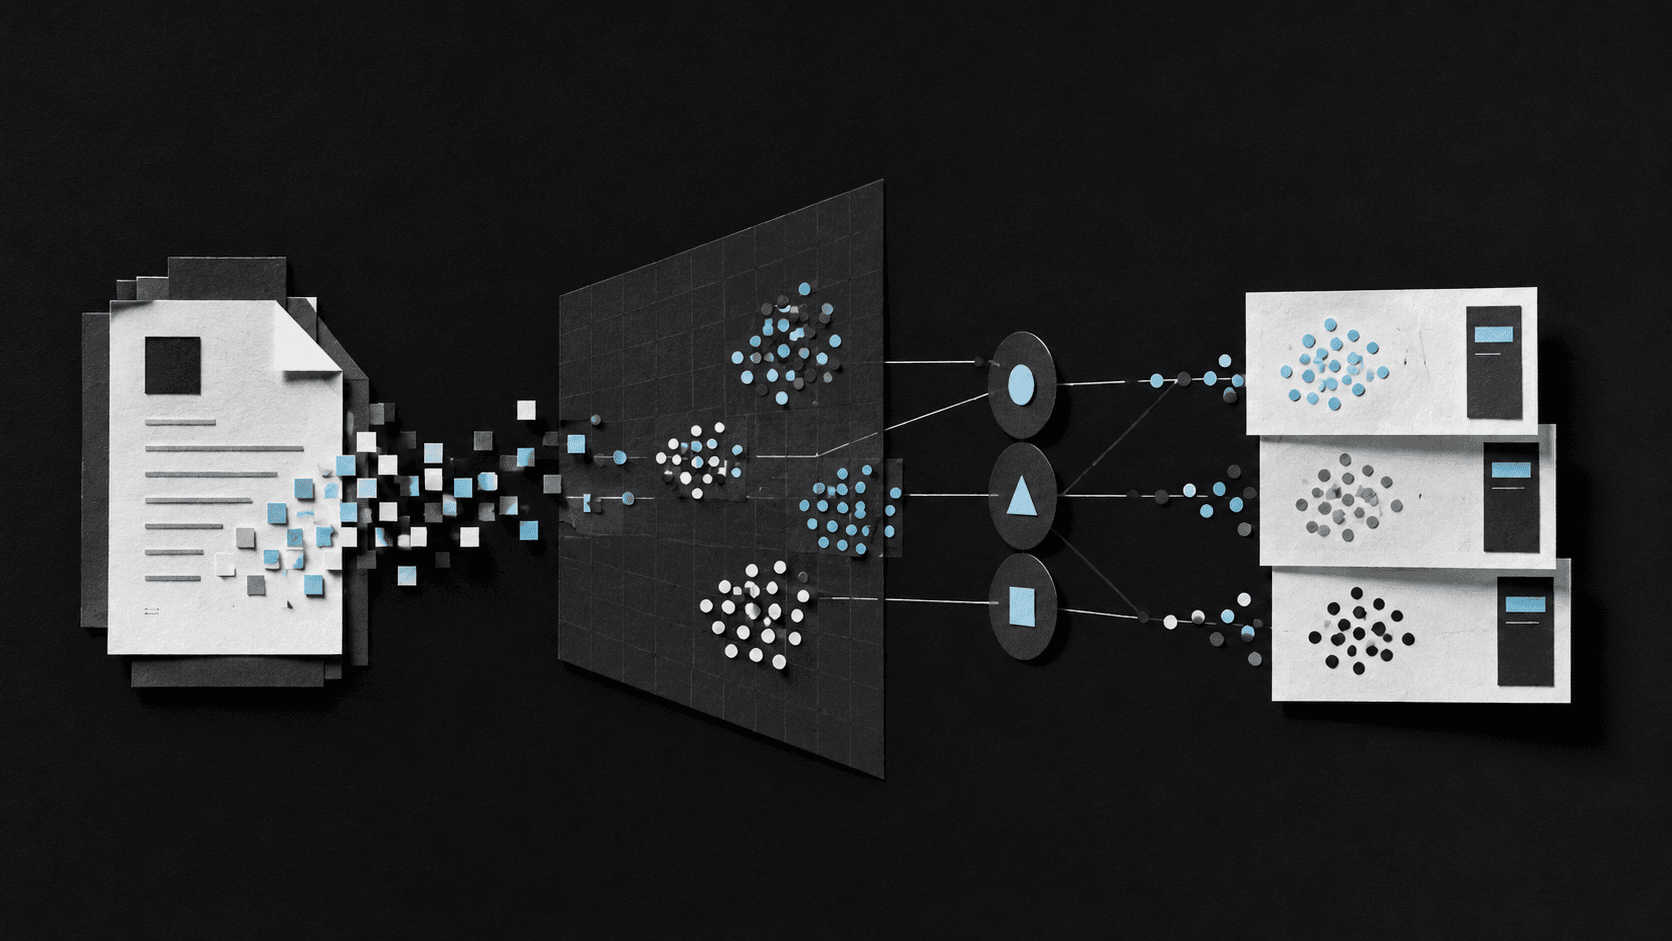
在知識庫(RAG)建構方面,單纯依赖 Embedding 密集向量檢索已無法满足高精度企業合規場景。結合 DeepSeek-V3 強大的長文字溯源能力,推薦落地混合檢索(Hybrid Search)漏斗:先通過向量與 BM25 分別召回 Top 100 候選,再經由 Cross-Encoder 重排器提取 Top 5 核心切片。
由於模型對中文語境下的法條、產品規範及專業術語有着敏锐的辨析度,切片上下文注入提示詞後,模型能夠準確標註引用來源段落,並在知識庫缺失對應資訊時果斷拒绝回答,真正杜绝捏造幻覺。
Tool Use 閉環:基於強 Schema 約束的企業工具編排
在 Agent 業務落地中,模型不僅要會回答,更要會下發指令呼叫內部微服務。通過在系統提示詞中定義標準的 JSON Schema,並開啟強制語法引導解碼(Constrained Decoding),DeepSeek-V3 能夠輸出严丝合缝的呼叫參數。
從根據使用者提問自動查詢 CRM 訂單狀態,到產生包含 SQL 過濾條件的內部報表,配合完備的參數合法性拦截器,企業能夠以极低邊際成本打通智慧代理與業務底層資料庫的最後一公裡。
參考來源
本文由 AI X Tool 基於公開資料研究後原創整理,發布日期與產品資訊可能變化,請以來源網站最新內容為準。