企業級 AI 閘道架構演進:流式語義快取、智慧限流與多模型容灾回退
在企業落地多大模型混合呼叫的複雜生產環境中,單點網络波動或供應商服務限流往往造成灾難性級聯故障。本文揭秘現代化 AI 閘道的核心設計:基於語義相似度的流式快取、自適應令牌桶限流與零感知無缝容灾調度。
- 語義快取一定要對使用者身份、時效性要求高的敏感提示詞進行严格的命名空間隔离與黑名單跳過。
- 流式輸出協議必須支援 Server-Sent Events (SSE) 分塊增量代理,避免一次性聚合等待损害使用者體驗。
- 在閘道層建立自動化金丝雀發布機制,新模型上線先切 5% 流量進行真實回答品質與延遲觀測。
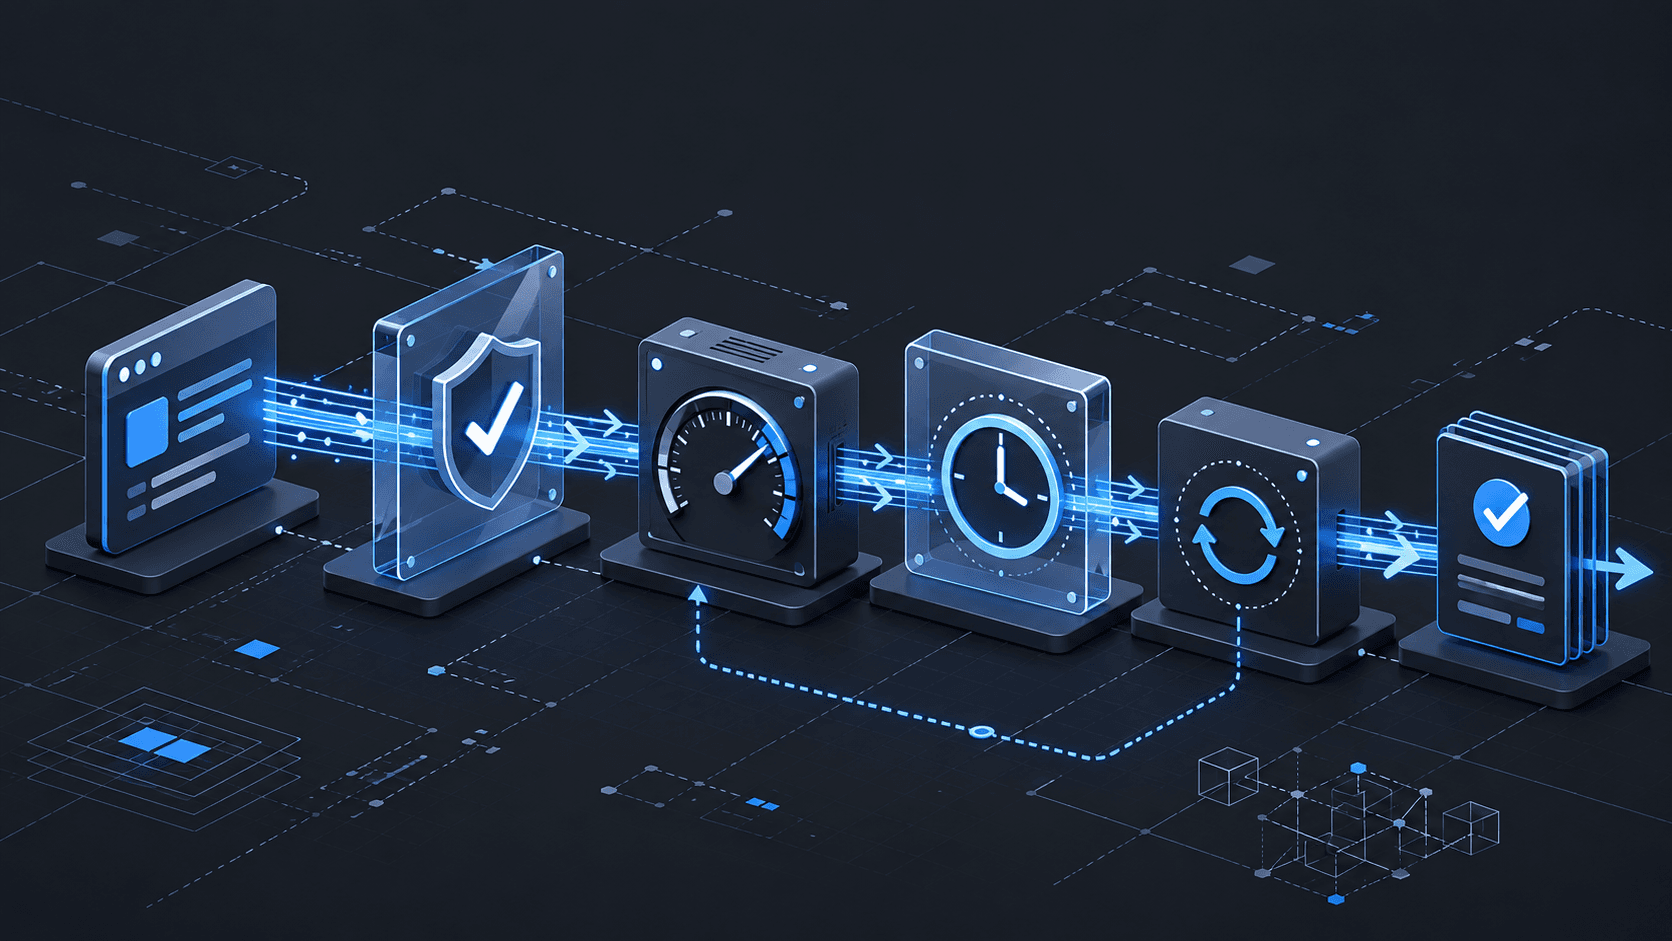
企業級高可用 AI 閘道核心轉發與熔斷拓扑
- 1請求標準化與敏感資訊脱敏過濾器
- 2毫秒級流式語義快取(Semantic Cache)探測
- 3動態配額限流與自適應滑動窗口熔斷
- 4跨云双活多模型智慧路由降級
架構痛點:直連大模型 API 在生產環境中的脆弱性
許多技術團隊在初期原型開發時,習惯在前端或單個微服務中直接通過 SDK 呼叫上游模型 API。但在業務規模擴大後,這種點對點直連架構迅速暴露出严重缺陷:廠商突發宕機導致業務全面瘫痪、超出每分鐘呼叫配額(TPM/RPM)遭遇頻繁 429 拦截、不同模型介面協議各異導致維護成本高昂。
建構統一的現代化‘企業級 AI 閘道(AI Gateway)’,成為企業大模型架構從玩具走向穩健生產系統的必經之路。
流式語義快取(Semantic Cache):毫秒級響應與降本神器
传統 HTTP 快取基於請求 URL 和請求頭的字符串完全哈希符合,面對使用者表述稍有差異(如‘怎麼退货’與‘退換货流程是什麼’)的提問完全失效。AI 閘道通過前置一個极輕量、超高速的向量嵌入模型,在 Redis 或專用向量庫中進行相似度余弦探測。
當相似度高於預設安全阈值(如 0.95)時,閘道直接讀取快取中歷史產生的回答並以 SSE 流式格式秒級推流回傳。不僅將使用者首字等待延遲(TTFT)從 2000ms 降至 20ms,更能直接削减企業數十個百分點的大模型 Token 採购成本。
高可用韧性設計:自適應限流、健康探測與透明容灾
生產級閘道的核心使命是保障服務不中斷。閘道內建了動態令牌桶限流器,按照組織、部門和 API Key 劃分獨立的速率與消費預算。一旦某專案接近預算红線,閘道將及時採取降頻保護,避免意外程式碼死循環耗尽全月額度。
更關鍵的是跨供應商故障轉移(Failover)能力。閘道對上游每個模型端點實施主動與被動健康探測。當主模型集群連續出現逾時或 5xx 錯誤時,熔斷器立即切斷流量,並按照預設的權重備選鏈路(如從 Claude 3.5 無缝轉入 DeepSeek-V3 或 GPT-4o),終端使用者完全無感中斷。
安全與合規審計:企業數位資產的守門人
除了效能與可用性,AI 閘道還是企業資料安全的關鍵防線。所有進出閘道的 Prompt 與 Completion 都會經歷即時的正则脱敏與敏感詞過濾,防止手機號、身份證和內部源碼等涉密資訊外洩至公共模型云端。
全鏈路紀錄的日志、成本帳單及效能打點資料,被統一汇總至監控大屏,為企業技術決策層提供了清晰的各業務線 AI 投資回報率(ROI)視圖與長線治理依據。
參考來源
本文由 AI X Tool 基於公開資料研究後原創整理,發布日期與產品資訊可能變化,請以來源網站最新內容為準。