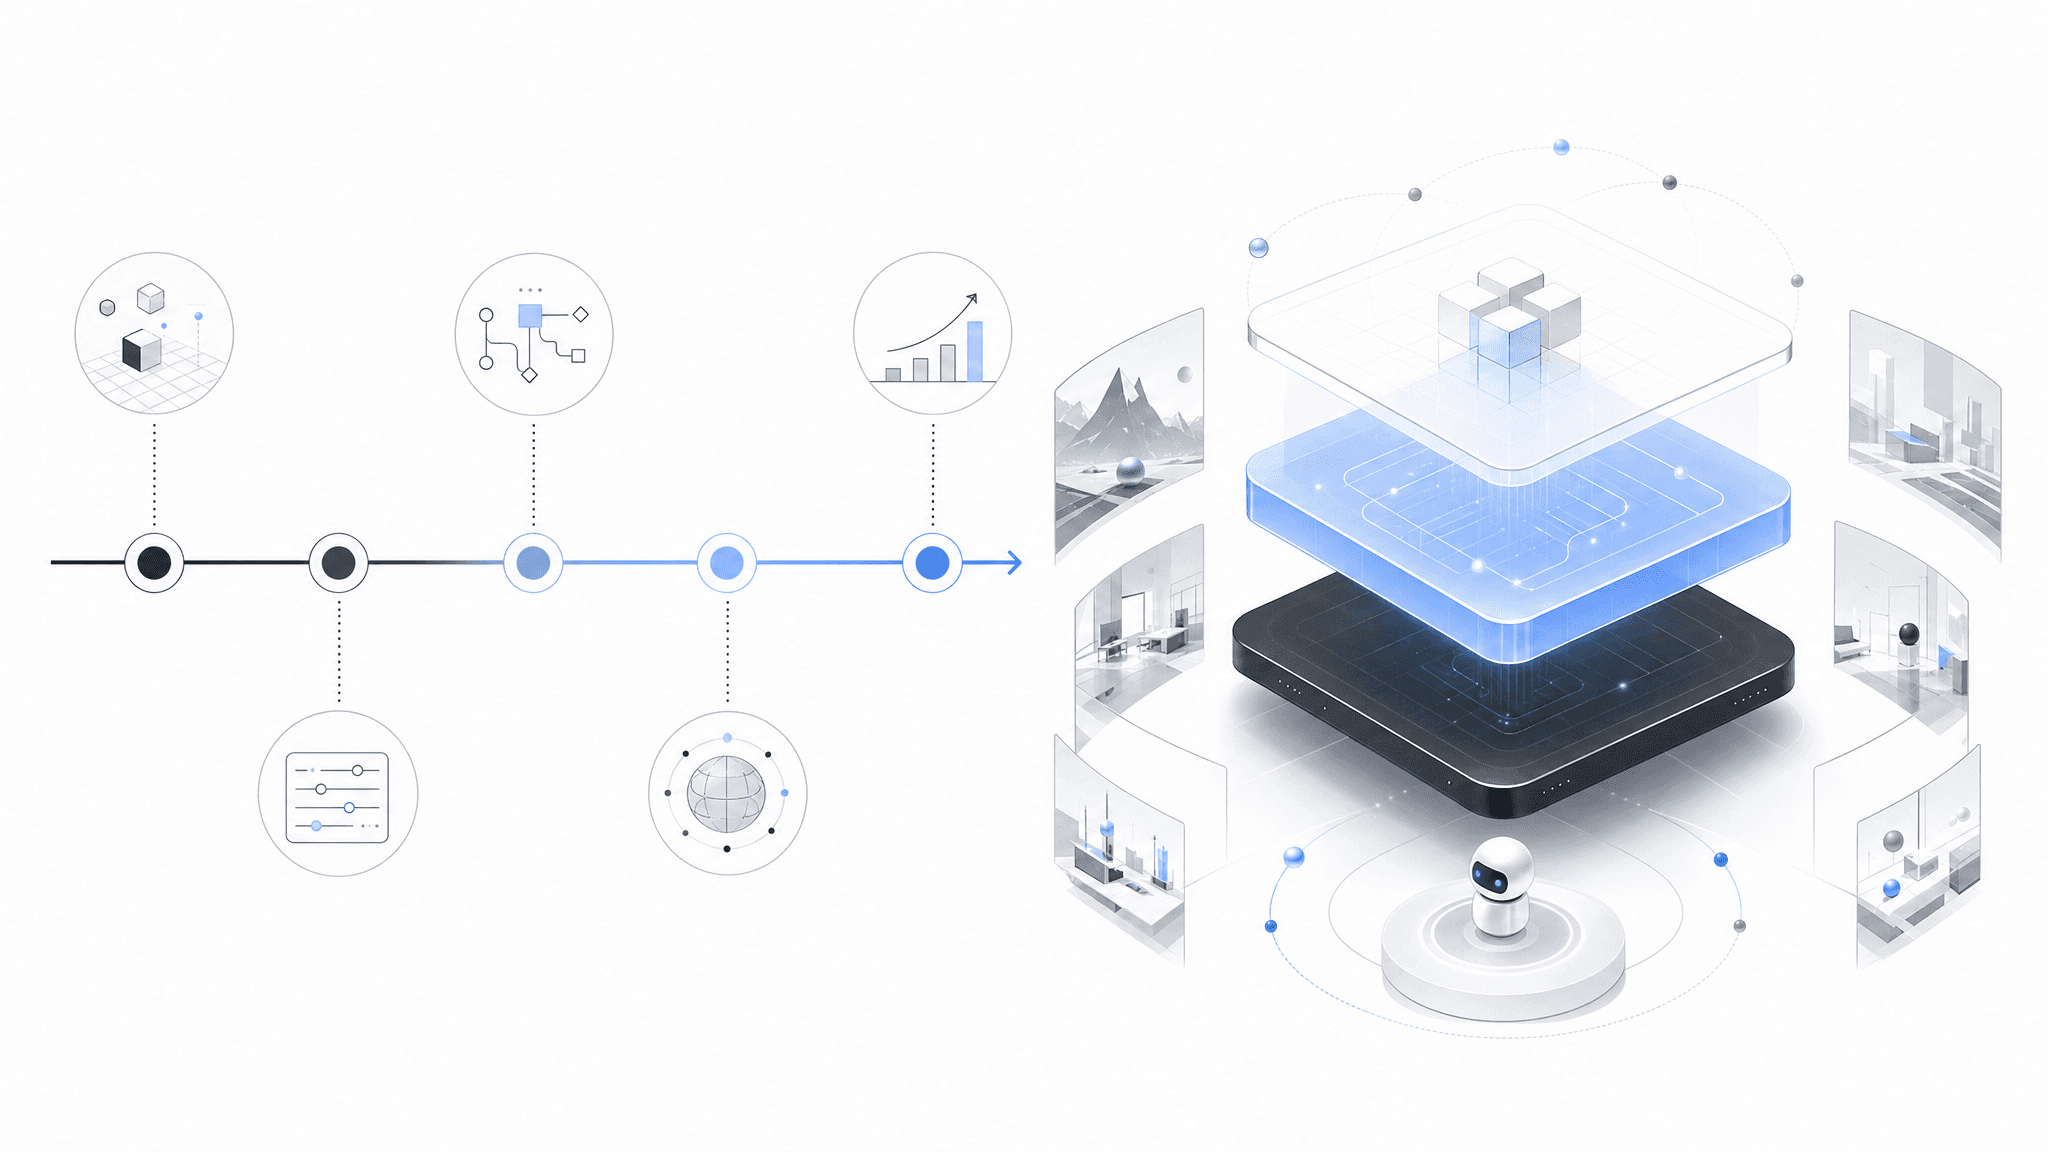
Google AI Introduces EnvHarness: A Programmable Layer That Turns Static Agent Environments Into Adaptive Training Worlds
Google Cloud AI Research, with Washington University in St. Louis and UNC Chapel Hill, has released EnvHarness, an Apache-2.0 layer that turns a static agent benchmark into one that adapts to the policy training on it. It wraps a frozen environment through the standard reset()/step() interface, so tasks and human-built verifiers stay untouched — and an LLM designer, EnvRigger, writes those wrapper
- 先核對來源和時間
- 把試用限制在可回滚範圍
- 對缺少獨立證據的結論保持觀望
事件時間線
- 1事件時間線
- 2關鍵機制
- 3真實使用場景
- 4限制與複核
發生了什麼
Google Cloud AI Research 聯合圣路易斯華盛顿大學與北卡罗來納大學教堂山分校的研究者,共同推出了一個可程式設計層 EnvHarness,專門用於把現有智慧代理基準環境改造為會隨訓練而自適應調整的訓練場。這層包装只通過標準的 reset 與 step 等介面與底層互動,既不改動模擬器、任務,也不動人工驗證器,因此可以直接串接已有的訓練管線。EnvHarness 內建三類可自由組合的組件:Stage 控制起始狀態,Contract 控制互動規則,Chain 把多個環境串聯起來。整套系統以 Apache-2.0 協議開源,並附帶六個環境的複現脚本,但因為依赖環境可重置,所以無法用於真實使用者帳戶與物理機器人。
真正讓 EnvHarness 自適應的核心,是它的 LLM 設計師 EnvRigger。EnvRigger 會先觀察五次基線 rollout,诊斷出策略中存在的系統性問題,然後寫出對應的 Python 組件,並放在五次新 rollout 上驗證;如果候選組件無解或過於簡單,就進入下一轮修訂。整個流程無需人工預先指定缺陷,因此能針對不同策略給出不同改造方案。
研究者在四類基準上展開測試,結果顯示訓練環境經過改造後明顯優於原始環境。在 ALFWorld 上,平均得分由 62.4 提升到 68.3,分布外子集提升 9.0 分;在 SWE-bench Verified 上,解決率由 49.88 提升到 52.58,平均步數由 55.01 降到 49.61,相對减少 9.8%。對比專門為软件工程設計的環境產生器 SWE-smith,EnvHarness 提升了 2.46 分,並少用 5.11 步。值得注意的是,文章指出 SpreadsheetBench 與 WebArena 上的若干技能在未改造環境中低於無技能基線,說明針對性設計對訓練穩定性確有影響。
最後,在 GRPO 訓練配合 Qwen3-8B-base 的設定下,重塑環境在四項指標中的三項優於原始環境;當環境規模擴充到 300 個時,得分進一步達到 54.79。論文 arXiv 編號為 2608.19880,對應 GitHub 倉庫與專案頁均已上線。
時間線與證據
文章於 2026 年 8 月 30 日發布,對應 arXiv 編號 2608.19880 的論文,配套的 GitHub 倉庫與專案頁面在發布當天同步上線,三家參與機構在署名中並列出現,依次為 Google Cloud AI Research、圣路易斯華盛顿大學與北卡罗來納大學教堂山分校。
EnvRigger 的工作循環按固定順序展開:先用五次基線 rollout 摸底,再诊斷其中反複出現的系統性缺陷,接着輸出 Stage、Contract 或 Chain 等 Python 組件,最後在五次新 rollout 上做驗證,必要時進入多輪修訂直到候選組件達到可解且有一定難度,這一序列在原文中被顯式画出。
實驗證據按從技能迁移到規模擴充的順序呈現。先在 ALFWorld 上紀錄到平均分從 62.4 升到 68.3、分布外子集提升 9.0 分的迁移結果;接着在 SWE-bench Verified 上看到解決率從 49.88 提升至 52.58、步數由 55.01 缩短到 49.01。SWE-smith 比較中 EnvHarness 多 2.46 分、少 5.11 步的差異同時列出。最後一項實驗把改造後的環境接進 GRPO 與 Qwen3-8B-base 的訓練流程,在四項指標中三項占優,並把環境數擴到 300 時取得 54.79 的分數。文中明確不覆蓋的內容包含 EnvRigger 所用具體模型、OfficeQA 的提升數位,以及 SpreadsheetBench 與 WebArena 的逐項得分。
具體變化
EnvHarness 對原有基準的改造體現在三個可獨立呼叫的層面:Stage 改寫環境的起始狀態,例如在 ALFWorld 中調整物體摆放以制造新的初始布局;Contract 重定義智慧代理在 step 中可以或不可以触發的動作,例如在 SWE-bench Verified 中限制可編輯的檔案範圍,從而把注意力集中到關鍵程式碼上;Chain 把多個環境前後串接起來,使一次訓練轨迹跨越不同場景。這三類組件由 EnvRigger 自動產生,而不是手工脚本,因此同一基準可以針對不同策略產生不同的改造組合。
EnvRigger 本身的輸出形態也是 Python 檔案,依據诊斷出的缺陷選擇 Stage、Contract 或 Chain,並直接插入到 reset 或 step 钩子中。由於不修改原始模擬器,這些新增組件可以隨時啟用或關閉,回到原始基準只需關閉相應钩子。改造後的環境與原始環境共享同一套驗證器,保證評估口径一致。
專案以 Apache-2.0 協議開源,隨倉庫一起發布六個環境的複現脚本,覆蓋 ALFWorld、WebArena、SWE-bench Verified 與 OfficeQA 等任務,使讀者能夠直接對照論文數位複現實驗。
對使用者的影響
對使用者的影響
對實際使用 EnvHarness 的研究者和工程師而言,最直接的變化是訓練環境可以根據自家策略的弱點自動調整,而不是依赖手工調參。EnvRigger 通過觀察五次基線 rollout 就給出改造方案,使用者只需在產生的 Python 組件基礎上選擇啟用或關閉,即可讓同一套基準在不同訓練階段呈現不同難度,避免每次策略更新都要重新寫場景脚本。
由於 EnvHarness 只通過 reset 與 step 這類標準介面工作,原有的模擬器、任務與人工驗證器都不必替換,使用者既可以把改造後的環境串接已有的訓練管線,也能隨時關閉钩子,把策略放回原始環境做對照評測,保證評估口径一致。
不過這套機制也附帶明確的適用邊界。EnvHarness 要求環境可重置,因此不能用於真實使用者帳戶,也無法直接控制物理機器人,這意味着涉及真實業務或硬件的研究者只能把它當作离線訓練或仿真階段的工具。此外,文中沒有披露 EnvRigger 內部所用的大模型型號,使用者在自行複現或擴充時只能依赖倉庫中給出的複現脚本。
限制與未知
EnvHarness 自身並未改動底層模擬器、任務和驗證器,而是通過 reset 與 step 钩子叠加組件,這種做法決定了它的能力上限。可重置是前提條件,因此真實使用者帳戶與物理機器人這類無法回到任意初始狀態的場景被排除在適用範圍之外,研究者只能把它限定在仿真或离線訓練階段。OfficeQA 在文中只是被列為被覆蓋的任務之一,但具體提升幅度並未給出數位,因此對該基準的實際收益無法從原文直接比較。SpreadsheetBench 與 WebArena 的逐項得分同樣未列出,文章只指出若干未改造的技能低於無技能基線,說明改造與否對訓練穩定性確有影響,但具體數值缺失。
關於 EnvRigger 內部的實現细節,文章同樣留下了若干空白。EnvRigger 充當 LLM 設計師,根據五次基線 rollout 诊斷缺陷並產生 Python 組件,但文中沒有披露它呼叫的是哪一類大模型,也沒有說明提示詞或採樣策略。使用者在自行擴充時,只能依赖倉庫中給出的複現脚本,而無法直接重複使用原文中使用的模型設定。整套專案以 Apache-2.0 協議開源,附帶六個環境的複現脚本,但文中沒有給出 2.0 之外的正式版本號,倉庫的穩定性與版本演進也未在原文範圍內說明。
論文方面,arXiv 編號 2608.19880 與 GitHub 倉庫、專案頁同步上線,但原文未交代正式發表場所與同行評審狀態,因此 EnvHarness 目前只能被視作預印本成果,方法與數位的最終確認仍需等待後續管道公開。推廣層面,文章提及 150k ML SubReddit 與 Telegram 頻道等管道,但並未對這些資訊的可靠性做進一步說明,使用者只能把 GitHub 與專案頁當作最直接的參考來源。
如何核對
要把 EnvHarness 論文中的數位與說法核回原文,主要靠两條路径。第一條是看倉庫裡隨論文一併發布的複現脚本。倉庫覆蓋了六個環境,其中 ALFWorld、WebArena、SWE-bench Verified 與 OfficeQA 都明確在列,使用者把脚本拉到本機、跑通基線與改造後两套設定,就能複現平均分 62.4 升到 68.3、分布外子集提升 9.0 分,以及 SWE-bench Verified 上解決率 49.88 升到 52.58、步數 55.01 降到 49.61 這一組數位;與 SWE-smith 對比中 2.46 分和 5.11 步的差異,也應能在同一脚本下重現。
第二條路径是對照論文字身的表述。文中明確說 EnvRigger 通過五次基線 rollout 诊斷缺陷,再輸出 Stage、Contract 或 Chain 類 Python 組件,並在五次新 rollout 上驗證,必要時多輪修訂,這一段可以在論文對應章節直接核對。GRPO 加 Qwen3-8B-base 訓練下四項指標中三項占優、環境擴到 300 個時得分 54.79 的描述,同樣屬於論文中可逐句比對的結論。
需要留意的是,文中並未披露 EnvRigger 呼叫的具體大模型型號,也沒有給出 OfficeQA 的提升數位、SpreadsheetBench 與 WebArena 的逐項得分。複現時,這几處只能依靠倉庫脚本的執行結果自行推算,原文層面無法直接核對。
讀者能做什麼
讀者若打算把 EnvHarness 引入自己的訓練流程,可以從倉庫裡拉取複現脚本作為起點。倉庫以 Apache-2.0 協議開源,隨論文一併發布,覆蓋 ALFWorld、WebArena、SWE-bench Verified 與 OfficeQA 等共六個環境,使用者把脚本跑通即可對照論文中平均分 62.4 升至 68.3、分布外子集提升 9.0 分,以及 SWE-bench Verified 上解決率 49.88 升至 52.58、步數由 55.01 缩至 49.61 等數位進行本機核對。
如果想讓 EnvRigger 針對自家策略產生改造方案,使用者只需準備一段可以重置的環境,讓 EnvRigger 先跑五次基線 rollout,再把產生的 Stage、Contract 或 Chain 類 Python 組件串接現有的 reset 與 step 钩子即可。這些組件可以單獨啟用或關閉,回到原始基準只需關閉對應钩子,原有模擬器與人工驗證器都不必替換。規模擴充方面,環境數擴到 300 時取得 54.79 分的結果,同樣能在倉庫脚本的複現流程中觀察到。
需要注意的是,EnvHarness 明確要求環境可重置,真實使用者帳戶和物理機器人被排除在外,使用者只能把它用於仿真或离線訓練階段。此外,原文沒有披露 EnvRigger 呼叫的大模型型號,也沒有給出 OfficeQA 的具體提升數位、SpreadsheetBench 與 WebArena 的逐項得分,複現時這几處只能依赖倉庫脚本的執行結果自行推算,無法與原文逐項對照。
後續觀察
從已披露的數位看,EnvHarness 的增益在跨任務與跨訓練方式两個維度都有體現。技能迁移層面,ALFWorld 的分布外子集提升 9.0 分,SWE-bench Verified 的平均步數從 55.01 降到 49.61,相對减少 9.8%;與领域專用環境產生器 SWE-smith 相比,EnvHarness 在同一基準上多拿 2.46 分且少用 5.11 步,說明通過 reset 與 step 钩子叠加可程式設計組件的路線,已經能對標甚至超越專門針對软件工程任務設計的方案。
在策略訓練層面,使用 GRPO 與 Qwen3-8B-base 進行訓練時,被改造版本在四項指標中的三項上跑赢原始版本;當環境數量擴充到 300 個,得分達到 54.79。這說明把同一套 EnvRigger 诊斷與產生機制嵌入到大規模 PPO 類流程中,重塑後的環境仍能持續提供訓練信號,而不是只在一次性評測中有效。
不過這些結果目前都來自 arXiv 編號 2608.19880 的預印本,GitHub 倉庫與專案頁虽然已經同步上線,但原文未交代正式發表場所與同行評審狀態,因此方法與數位的最終確認仍需等待後續管道公開。SpreadsheetBench 與 WebArena 的逐項得分文中未給出,只指出若干未改造技能低於無技能基線;OfficeQA 虽然被列為覆蓋任務,但具體提升幅度也沒有披露。EnvRigger 內部呼叫的大模型型號同樣缺失,使用者只能依靠倉庫中以 Apache-2.0 協議開源的複現脚本進行本機核對,再決定是否把它納入下一階段的訓練管線。
參考來源
本文由 AI X Tool 基於公開資料研究後原創整理,發布日期與產品資訊可能變化,請以來源網站最新內容為準。