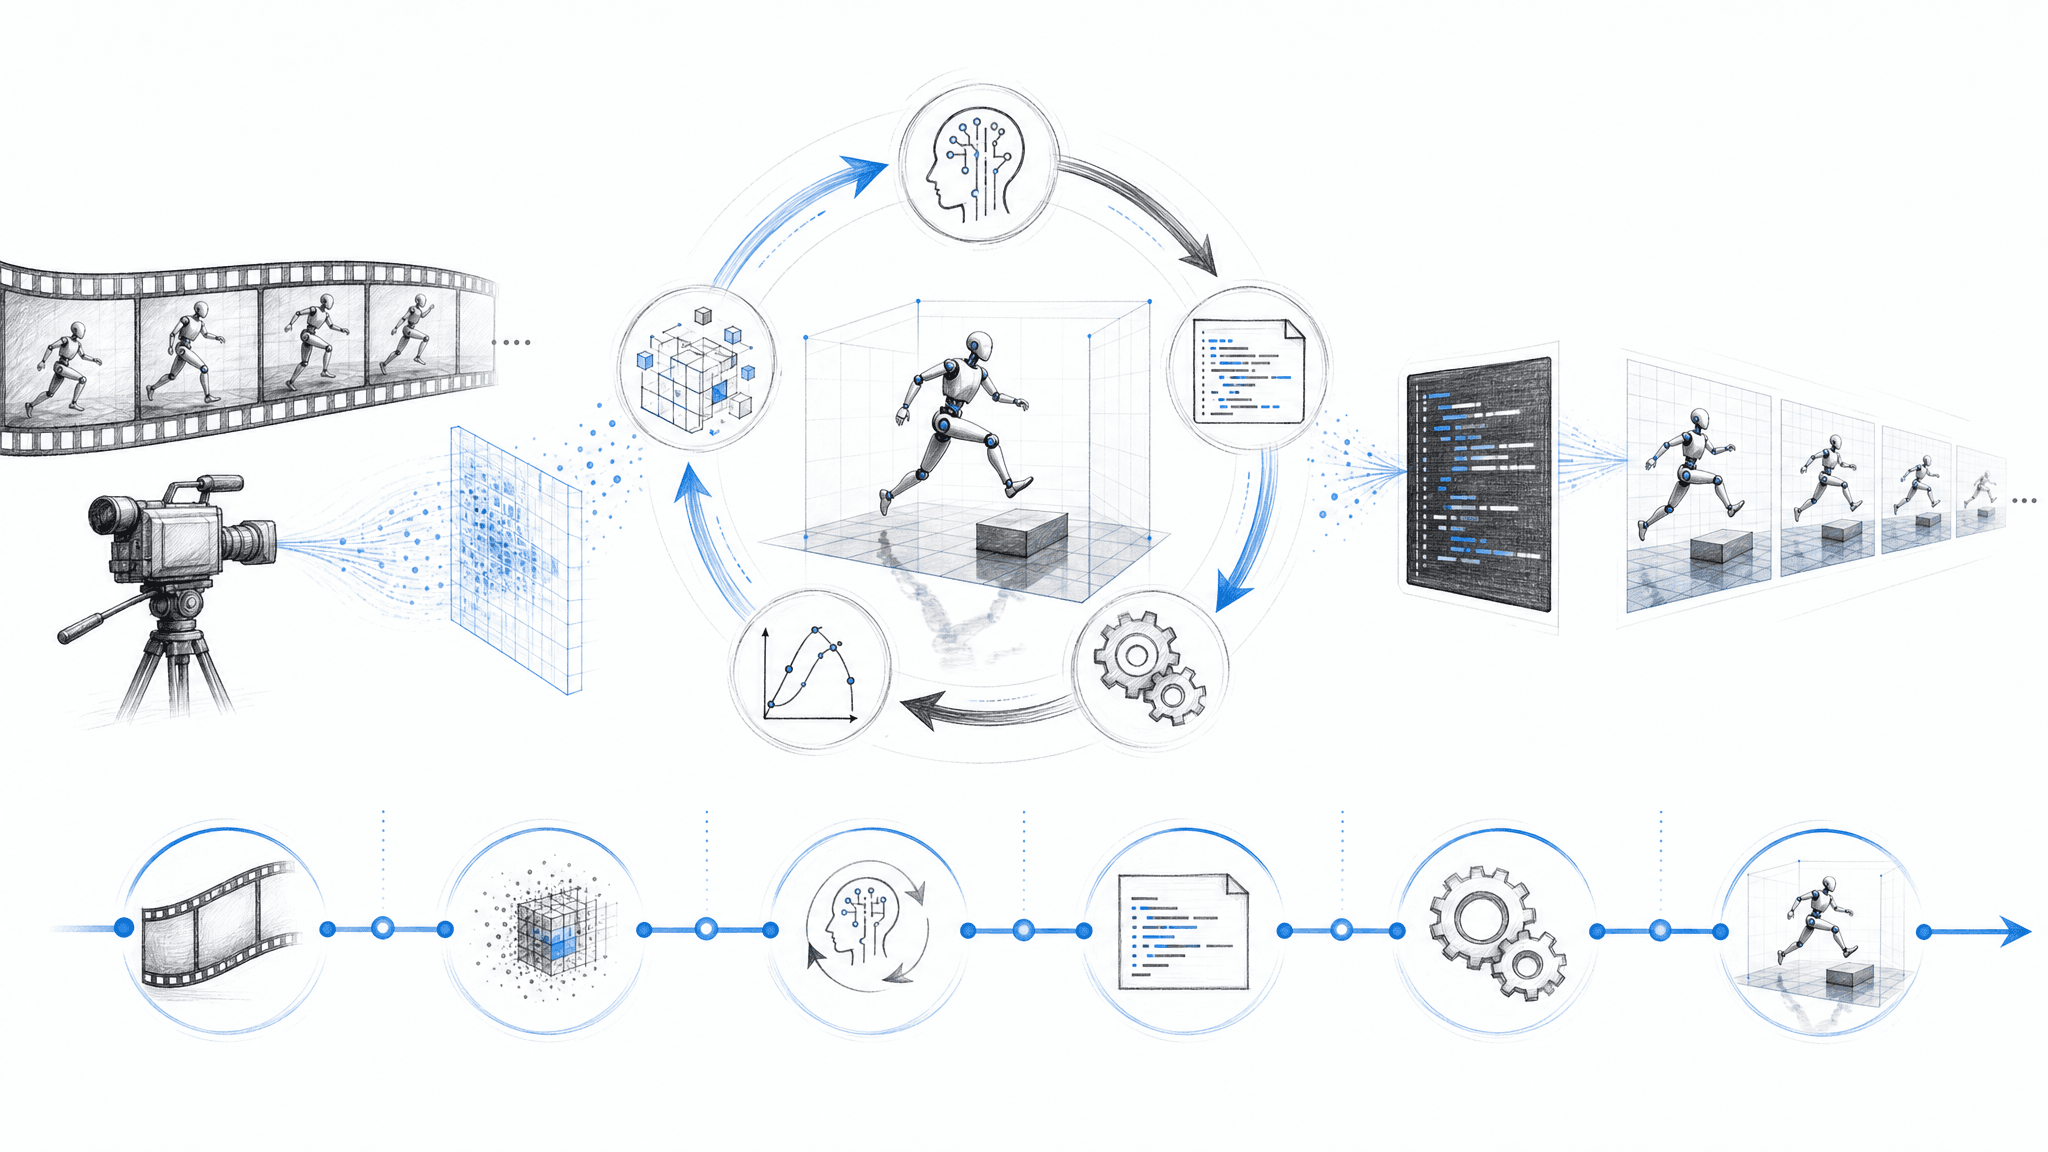
Meet ‘Code-as-World’: An Agentic Loop That Rewrites Real Videos Into Executable MuJoCo Physics Programs
Code-as-World recovers editable MuJoCo scene code from real video, then uses those verified worlds to train physical reasoning. The post Meet ‘Code-as-World’: An Agentic Loop That Rewrites Real Videos Into Executable MuJoCo Physics Programs appeared first on MarkTechPost .
- 先核對來源和時間
- 把試用限制在可回滚範圍
- 對缺少獨立證據的結論保持觀望
事件時間線
- 1事件時間線
- 2關鍵機制
- 3真實使用場景
- 4限制與複核
發生了什麼
MirroS 推出了名為 Code-as-World 的範式,核心思路是把物理場景編碼成可執行程式,最終產生 scene.json 並交由 MuJoCo 物理引擎執行。系統採用智慧代理循環結構,從一段真實影片出發反複試錯與改寫,最多進行 5 轮迭代,逐步逼近可被物理引擎重建的場景程式。
為了讓方案可直接重複使用,官方同步開源了 GitHub 倉庫,並釋出两個模型檢查點:Code-as-World-VL-4B 與 Code-as-World-VL-9B,均採用 Apache 2.0 許可。两個模型分別由 Qwen3.5-4B 與 Qwen3.5-9B 微調得到,以 BF16 safetensors 形式部署,通過 vLLM 提供服務,並對外暴露兼容 OpenAI 規範的 /v1 介面。推理時,每段輸入影片會被採樣為 16 幀,同時把 `--max-model-len` 設為 4608。
可執行世界表示 EWR 被形式化為三元組 p = (C, E, A),分別對應場景構成、狀態演化與外觀渲染三部分,用以統一刻画可被 MuJoCo 複現的世界。在實現鏈路中,團隊組合了三類視覺模型:SAM 3 负責實例掩碼並輸出圖像平面轨迹,VGGT-Omega 提供深度與相機几何估計,SAM 3D 则逐物體重建網格几何。
訓練分為两個階段。第一階段使用 73,335 個圖像空間問答對進行監督微調;第二階段引入世界空間樣本,包含 1,585 條文字驱動與 988 條影片驱動的可執行世界資料,並在此基礎上施加 GRPO 訓練。整套訓練消耗 8 塊 NVIDIA H100 GPU 完成。
在 QuantiPhy 驗證集(159 項、採用 MRA 宏平均,覆蓋 2S/2D/3S/3D 四類設定)上,4B 與 9B 版本分別取得 50.6 與 55.4,27B 推理版本進一步升至 58.6。對比同基準結果,Gemini-3.1 Flash 得 54.8,ChatGPT-5.1 得 48.4,Qwen3-VL-32B-Instruct 得 40.2。消融實驗表明,僅依赖圖像空間訓練時,4B 與 9B 分別只有 44.2 與 50.9;加入两類世界空間資料後,分別提升至 50.6 和 55.4,驗證了世界空間監督與 GRPO 的贡献。
時間線與證據
來源材料給出的最早可核對時間點是網頁發布時間 2026-08-30T01:35:02+00:00,材料中並未單獨標註 Code-as-World 範式的正式發布日,相關披露與開源動作均在同一時間窗內由 MirroS 一併放出:GitHub 倉庫、两個模型檢查點以及配套技術報告同步公開。
專案落地的關鍵事件按先後順序可梳理為三條線。第一條是模型與程式碼資產線,倉庫釋出同時附帶 Code-as-World-VL-4B 與 Code-as-World-VL-9B 两個 BF16 safetensors 檢查點,均採用 Apache 2.0 許可,前者由 Qwen3.5-4B 微調而來,後者基於 Qwen3.5-9B,並統一通過 vLLM 提供兼容 OpenAI 規範的 /v1 介面,推理侧固定每段影片採樣 16 幀並將 `--max-model-len` 設為 4608。第二條是表示與實現線,團隊把可執行世界表示 EWR 形式化為 p = (C, E, A) 三元組,分別刻画構成、演化與外觀,並組合 SAM 3、VGGT-Omega、SAM 3D 三類模型完成實例掩碼、圖像平面轨迹、深度與相機几何以及逐物體網格重建,最終產生 scene.json 交由 MuJoCo 執行。第三條是訓練與評測線,模型訓練先後經歷圖像空間 73,335 對問答對的監督微調,以及在 1,585 條文字驱動與 988 條影片驱動可執行世界資料上施加 GRPO,消耗 8 塊 NVIDIA H100 GPU 完成;評測端使用 QuantiPhy 驗證集的 159 項、MRA 宏平均、覆蓋 2S/2D/3S/3D 四類設定,得到 4B 50.6、9B 55.4、27B 推理版本 58.6 的結果,並給出 Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4、Qwen3-VL-32B-Instruct 40.2 的對照數位。
具體變化
相比此前的視覺理解方案,Code-as-World 把輸出形式從文字描述或檢測框改為可被 MuJoCo 直接執行的 scene.json 程式。為支撑這一改變,團隊引入了三類視覺模型協同工作:SAM 3 給出實例掩碼與圖像平面轨迹,VGGT-Omega 提供深度與相機几何,SAM 3D 负責逐物體重建網格几何,三者輸出共同驱動程式碼產生。
在模型侧,官方同步放出两個 BF16 safetensors 檢查點 Code-as-World-VL-4B 與 Code-as-World-VL-9B,分別由 Qwen3.5-4B 與 Qwen3.5-9B 微調而來,統一經由 vLLM 對外暴露兼容 OpenAI 規範的 /v1 介面。推理侧固定每段影片採樣 16 幀,並把 `--max-model-len` 設為 4608。
訓練安排也做了相應調整。第一階段使用 73,335 個圖像空間問答對進行監督微調;第二階段轉向世界空間,引入 1,585 條文字驱動與 988 條影片驱動的可執行世界樣本,並施加 GRPO 訓練,硬件上消耗 8 塊 NVIDIA H100 GPU 完成。
評測端採用 QuantiPhy 驗證集,159 項任務、以 MRA 宏平均,覆蓋 2S、2D、3S、3D 四類設定。結果顯示,4B 版本得分 50.6,9B 版本升至 55.4,27B 推理版本進一步達到 58.6;同期對照 Gemini-3.1 Flash 取得 54.8,ChatGPT-5.1 取得 48.4,Qwen3-VL-32B-Instruct 取得 40.2。消融實驗中,僅依赖圖像空間訓練時 4B 與 9B 分別僅有 44.2 與 50.9,加入两類世界空間資料後分別提升至 50.6 與 55.4,說明世界空間監督與強化學習訓練共同推動了效能變化。
對使用者的影響
對於希望用真實影片驱動物理仿真的研究者與工程師,Code-as-World 把輸入從人工標註的物體參數換為一段影片,配合最多 5 轮的智慧代理循環重寫,輸出可直接交由 MuJoCo 執行的 scene.json,免去手工搭建場景的步驟。
部署門檻方面,官方釋出的两個 Apache 2.0 檢查點 Code-as-World-VL-4B 與 Code-as-World-VL-9B 分別基於 Qwen3.5-4B 與 Qwen3.5-9B,以 BF16 safetensors 形式經由 vLLM 提供服務,並通過兼容 OpenAI 規範的 /v1 介面對外暴露,呼叫侧只需按每段影片採樣 16 幀並把 `--max-model-len` 設為 4608 即可啟動推理,模型與上游基座的归屬關系在倉庫中標註清晰,便於二次微調或替換。
效果上,使用者拿到的不只是文字描述,而是可被 MuJoCo 複現的可執行世界表示 EWR,其三元組 p = (C, E, A) 分別對應構成、狀態演化與外觀渲染,配合 SAM 3 實例掩碼與圖像平面轨迹、VGGT-Omega 深度與相機几何以及 SAM 3D 逐物體網格,可直接用於下游物理仿真、控制策略訓練或具身智慧任務。
QuantiPhy 驗證集(159 項、MRA 宏平均、覆蓋 2S/2D/3S/3D)的對比結果顯示,4B 與 9B 版本分別取得 50.6 與 55.4,27B 推理版本進一步升至 58.6,優於同基準下的 Gemini-3.1 Flash(54.8)、ChatGPT-5.1(48.4)以及 Qwen3-VL-32B-Instruct(40.2),讓中小參數規模模型在物理推理任務中也能取得相對靠前的名次。
訓練流程同樣開放,使用者可以參照两階段路線複現:第一階段在 73,335 個圖像空間問答對上做監督微調,第二階段引入 1,585 條文字驱動與 988 條影片驱動的可執行世界資料並施加 GRPO,整個過程使用 8 塊 NVIDIA H100 GPU 完成,為後續在自有資料上做繼續訓練或強化學習微調提供了可對齊的基線脚本與硬件預算參考。
限制與未知
來源材料在多個關鍵處留下了未交代的细節,使用者按現有公開資訊難以獲得確切答複。
在時間維度上,網頁發布時間 2026-08-30T01:35:02+00:00 是目前唯一可核對的客觀時間戳,材料並未單獨披露 Code-as-World 範式的正式發布日,也無法判斷訓練完成、開源、報告成稿等節點之間的時間間隔。
在模型資產層面,27B 推理版本的具體名稱、是否同步開源、是否同樣採用 Apache 2.0 許可以及如何獲得,材料中均未給出,只能確認其在 QuantiPhy 驗證集上取得 58.6 這一結果。
在資料建構層面,73,335 個圖像空間問答對的來源篩選規則與建構细節未在材料中給出,其內部是否细分為 RefCOCO/RefCOCO+/RefCOCOg、RefCLEF、GOT-10K 等子集以及各自數量比例同樣未披露。
在訓練策略層面,第二階段使用的 GRPO 具體超參與奖励權重數值未在材料中給出,無法據此判斷訓練成本與效果之間的權衡;候選影片經過運動聚焦過濾後剩余的具體數量也未公開,5 轮評測預算下與 Best-of-5 獨立採樣之間的具體數值差距亦未提供。
在評測層面,材料僅說明 QuantiPhy 驗證集包含 159 項、採用 MRA 宏平均、覆蓋 2S/2D/3S/3D 四類設定,但每類設定下樣本數量分布以及 27B 版本是否在完全相同的設定下評測未做說明。
如何核對
要核對 Code-as-World 的各項细節,使用者可顺着範式名稱與作者署名回到源頭。MarkTechPost 網頁正文明確署名為 MirroS 發布,文末給出 GitHub 倉庫連結,並附上技術報告與 Code-as-World-VL-4B、Code-as-World-VL-9B 两個模型卡頁面,模型卡頁面可直接確認 Apache 2.0 許可條款與 BF16 safetensors 權重格式,從權重卡片能夠讀到基座分別標註為 Qwen3.5-4B 與 Qwen3.5-9B。
推理侧的具體數值同樣需要在倉庫的部署脚本或 README 中核對。網頁摘要給出的两條設定是每段影片採樣 16 幀與 `--max-model-len 4608`,使用者應檢查倉庫內的 serve 或 launch 脚本,確認命令行參數名稱、是否僅在 OpenAI 兼容 `/v1` 介面下生效,以及預設採樣策略是否一致。
視覺模型棧的归屬可通過論文附錄或倉庫依赖清單核對。網頁摘要列出的三項組件 SAM 3 實例掩碼與圖像平面轨迹、VGGT-Omega 深度與相機几何、SAM 3D 逐物體網格,應在論文的模型章節對應到具體版本號與權重來源,確認三者輸出是否確實汇入 scene.json 的構成、演化與外觀三元組 p = (C, E, A)。
訓練流程的核對重點在两階段資料規模與硬件設定。第一階段 73,335 個圖像空間問答對、第二階段 1,585 條文字驱動與 988 條影片驱動樣本,以及 8 塊 NVIDIA H100 GPU 的設定,應在技術報告或倉庫訓練設定檔案中找到對應數位,並留意是否注明資料來源篩選規則。
評測結果的核對應回到 QuantiPhy 驗證集原條目,確認其包含 159 項、採用 MRA 宏平均、覆蓋 2S、2D、3S、3D 四類設定,再把網頁給出的 4B 50.6、9B 55.4、27B 推理版本 58.6、Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4 與 Qwen3-VL-32B-Instruct 40.2 逐項對齊。消融實驗中僅圖像空間訓練得到的 44.2 與 50.9,以及加入两類世界空間資料後的 50.6 與 55.4,也應在報告消融表格中找到相同來源。
材料未明確給出 27B 推理版本名稱、GRPO 超參與奖励權重、候選影片經運動聚焦過濾後的剩余數量,以及 Best-of-5 獨立採樣與 5 轮預算的具體差距,使用者遇到相關問題應直接聯絡作者或在倉庫 issue 中求證,而非基於網頁摘要推斷。
讀者能做什麼
讀者可以直接前往 MirroS 在 MarkTechPost 文末給出的 GitHub 倉庫,下載 Code-as-World-VL-4B 與 Code-as-World-VL-9B 两個 Apache 2.0 檢查點,按模型卡頁面紀錄的 BF16 safetensors 格式與 Qwen3.5-4B、Qwen3.5-9B 基座归屬完成權重加載,並通過 vLLM 暴露的兼容 OpenAI 規範的 `/v1` 介面發起請求,把命令行中每段影片採樣 16 幀與 `--max-model-len` 設為 4608 作為最小推理設定。
拿到模型後,讀者只需向智慧代理循環投入一段真實影片,由其在最多 5 轮內反複改寫,最終輸出可直接交由 MuJoCo 執行的 scene.json,從而跳過手工搭建物體參數與場景布線的步驟,把可執行世界表示 EWR 的三元組 p = (C, E, A) 立即串接下游物理仿真、控制策略訓練或具身智慧任務。
若計畫在自有資料上繼續訓練,可以參照倉庫內公開的两階段脚本:先用 73,335 個圖像空間問答對做監督微調,再在 1,585 條文字驱動與 988 條影片驱動的可執行世界資料上施加 GRPO,整套流程在 8 塊 NVIDIA H100 GPU 上完成,為繼續微調或強化學習對齊提供可重複使用的基線預算。
在 QuantiPhy 驗證集(159 項、MRA 宏平均、覆蓋 2S/2D/3S/3D)上,本機複跑 4B 與 9B 即可對照 50.6 與 55.4 這两個官方分數,並參考同基準下 Gemini-3.1 Flash 54.8、ChatGPT-5.1 48.4 與 Qwen3-VL-32B-Instruct 40.2 驗證自家部署是否一致;消融實驗中僅圖像空間訓練得到的 44.2 與 50.9,以及加入两類世界空間資料後回到 50.6 與 55.4 的曲線,也可在同一基準上重測以確認世界空間監督與 GRPO 的實際增益。
後續觀察
從消融曲線可以看出,世界空間監督與 GRPO 是模型從圖像空間能力迁移到可執行世界表示的關鍵推力。僅靠 73,335 個圖像空間問答對做監督微調,4B 與 9B 在 QuantiPhy 上分別只有 44.2 與 50.9;叠加 1,585 條文字驱動與 988 條影片驱動的可執行世界資料後,两個模型立即回升到 50.6 與 55.4,與最終公開分數完全對齊,說明這部分資料帶來的增益相對集中且方向單一。
值得注意的是,27B 推理版本虽然未公布名稱與權重,却在同一驗證集上把分數推到 58.6,超過同基準下 Gemini-3.1 Flash 的 54.8,也明顯领先 ChatGPT-5.1 的 48.4 與 Qwen3-VL-32B-Instruct 的 40.2。這條曲線意味着在物理一致性這種結構化判斷任務裡,中小參數規模模型叠加程式化中間表示後,仍有繼續上探的空間,同時也讓 4B 與 9B 的相對位置更接近可用基線,而非纯粹依赖規模取胜。
對工程使用而言,5 轮智慧代理循環把輸出锁定在 MuJoCo 可直接讀取的 scene.json,配合 SAM 3 實例掩碼與圖像平面轨迹、VGGT-Omega 深度與相機几何、SAM 3D 逐物體網格這一視覺棧,意味着從原始影片到可執行物理場景的整條鏈路都不需要使用者手工串接額外几何重建模塊,可直接進入下游仿真或策略訓練。
隨着 Apache 2.0 同時覆蓋程式碼、權重與技術報告,社群可以在 Qwen3.5-4B 與 Qwen3.5-9B 之上繼續做微調或強化學習,而 8 塊 NVIDIA H100 的硬件門檻也為後續複現提供了相對明確的預算參考。
參考來源
本文由 AI X Tool 基於公開資料研究後原創整理,發布日期與產品資訊可能變化,請以來源網站最新內容為準。