多模態影片生成與時間線控制:從首尾幀锚定到分鏡連續性實戰
影片生成技術正從“隨機盲盒產生”迈向“可控參數化導演”。本文深入剖析如何通過首尾幀關鍵幀锁定(First/Last Frame Control)、深度圖引導與時間線分鏡拆解,打造商業級長影片與動態分鏡工作流程。
- 绝對不要在一個 5 秒影片的單一提示詞中堆砌過多連贯動作,遵循‘一個鏡頭传達一個主體動量’的影視構圖準则。
- 將前一個鏡頭的最終產生幀作為下一個鏡頭的起始幀,是串聯分鐘級故事片最穩妥的連續性技巧。
- 出片時統一保留元資料與運動矢量標記,便於在後期剪辑软件中進行變速曲線與調色符合。
影片生成首尾幀插值與時間線連續性管線
- 1剧本拆分與鏡頭語言標準化(Shot Breakdown)
- 2靜態首尾幀產生與角色資產特征對齊
- 3運動轨迹、摄影機運鏡與物理約束產生
- 4時空潜空間插值與分段無缝融合渲染
技術演進:從盲盒式文字生影片到導演級精確制導
早期文字產生影片工具常被從業者戏称為‘算力抽卡’——輸入一段唯美的提示詞,輸出的画面虽然視覺惊艳,但往往充斥着不自然的多肢體、物體溶解以及無法預測的運鏡穿模。在需要精確剧情把控的廣告行銷與影視製作中,這種不可預測性极大制約了商業化落地。
而新一代影片基礎模型(如 Sora、Runway Gen-3 以及 Gemini Omni 系列)的核心變革,在於引入了對物理時空連續性與多模態條件的深度控制能力。影片創作者開始擁有與传統三維软件類似的鏡頭控制權。
首尾幀控制(First/Last Frame):锁死動作起點與終點
在可控影片管線中,‘首尾幀锁定’被證明是最具工業價值的核心功能。創作者可以通過高精度的文生圖或實拍素材指定鏡頭的第 0 秒画面(首幀)與第 5 秒画面(尾幀)。
擴散模型在此基礎上的任務從‘憑空想像時空’轉變為‘在两幀之間計算最符合現實物理規律的運動插值路径’。這不僅彻底解決了角色面部與環境光影在運鏡中的跳跃問題,更允許複雜的互動動作(如杯子從桌上拿起移至嘴邊)能夠精確到達指定位置。
多鏡頭敘事策略:角色一致性與鏡頭接戏(Continuity)
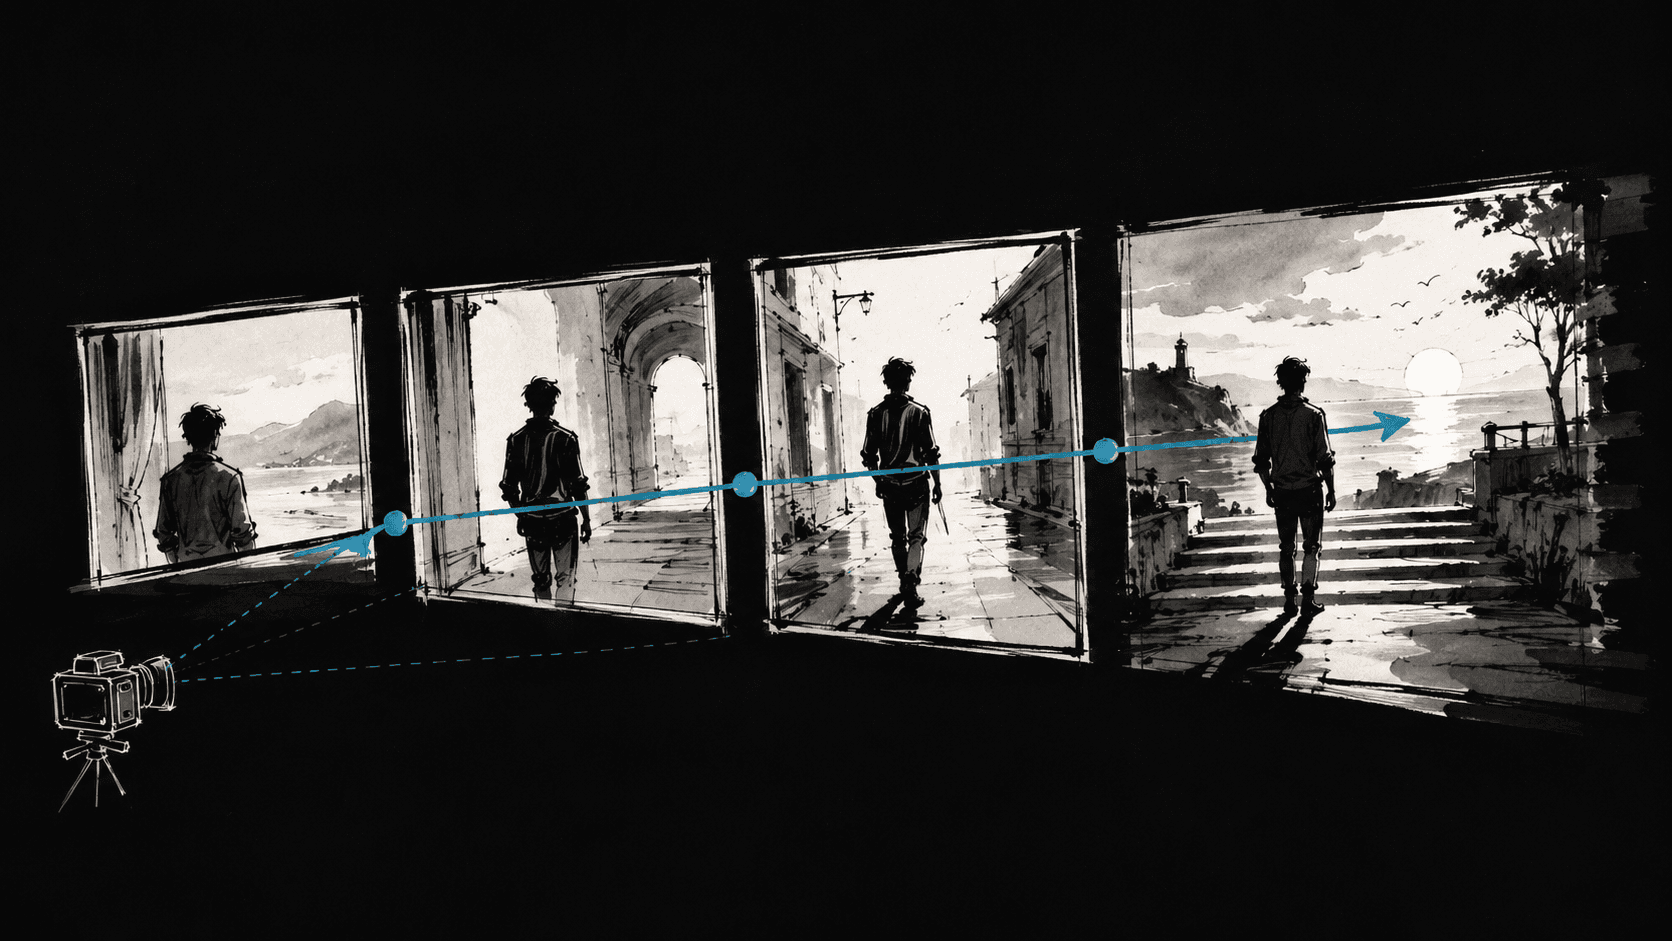
製作一部完整的剧情短片需要數十個分鏡。如何在不同景別(特寫、中景、全景)之間保持同一角色和環境的視覺特征?實踐中成熟的工作流程是建立‘角色視覺資產包’。
利用參考圖像嵌入(Reference Latent Embedding)或專屬微調權重,先批次產出多角度的角色立繪。在產生具體鏡頭時,將角色資產作為恒定條件传入,同時严格將上一個鏡頭的尾幀提取為下一個鏡頭的視覺基準,確保鏡頭交接處的景深和色調浑然一體。
工業化渲染管線:降本提效的二階段工作流程
高分辨率影片生成极其昂貴且耗時。高效的製作流程必然遵循‘草稿驗證 -> 終稿上採樣’的二階段法则。前期用 360p 或 540p 极速模式跑通全部分鏡的分鏡脚本與動效節奏,確認剪辑轴線無误後再開啟 1080p 或 4K 的高品質渲染。
通過將現代影片大模型與成熟的非線性編輯工具相結合,獨立創作者與小型製作團隊正以惊人的效率產出過去需要好莱坞特效團隊數月才能完成的動態視覺大片。
參考來源
本文由 AI X Tool 基於公開資料研究後原創整理,發布日期與產品資訊可能變化,請以來源網站最新內容為準。